
Урок
2.1 Настраиваем Claude Code на работу с OpenRouter, локальной LM Studio, или корпоративной моделью Qwen 3.6 27B
Сегодня мы установим Claude Code и настроим его на работу с другими LLM-провайдерами. Разумеется, вы можете работать и с обычной облачной подпиской Anthropic, но в этой статье я хочу рассказать, как можно подключать другие модели, например такие, которые обеспечивают скорость 1000 токенов в секунду! И разжую, какие могут возникнуть сложности и как с ними разобраться.
Ставим обычный облачный Claude Code
Обратите внимание, есть десктопная версия, которую можно скачать отсюда https://claude.ai/downloads , но нам нужна другая, консольная. В чем ее прелесть - так это в том, что ее можно поставить на ваш удаленный сервер и прямо из консоли что-то править через SSH.
macOS / Linux / WSL (подсистема Windows для Linux)
curl -fsSL https://claude.ai/install.sh | bash
Windows (через PowerShell)
irm https://claude.ai/install.ps1 | iex
Заходим в папку проекта в терминале и пробуем запустить:
claudeПоначалу оно может потребовать довольно простую настройку, но у меня уже все настроено.
Отличия OpenAI-compatible ендпойнтов от ендпойнтов Claude code
Основная разница в том, то что для получения ответа модели используют разные пути запросов.
Эта информация нам понадобится, если мы захотим подключить другие модели к Claude Code и не зависеть от подписки. Такая возможность имеется.
Эндпойнты OpenAI- совместмые API
Этот стандарт разработан для текстовых транзакций (REST API). Все эндпойнты имеют строгий префикс версионирования (обычно /v1/):
POST /v1/chat/completions: Главный рабочий эндпойнт. Принимает массивmessagesс ролями (system,user,assistant) и возвращает сгенерированный текст или JSON для Tool Calling.GET /v1/models: Возвращает структурированный список всех доступных на данном сервере моделей (например,gpt-4o,llama-3,deepseek-coder).
Эндпойнты инфраструктуры Claude Code
Claude Code работает c с другими ендпойнтами, и чтобы работать с другой неродной моделью, необходимо, чтобы она их тоже поддерживала.
POST /v1/messages: Нативный эндпойнт Anthropic, через который Claude Code общается с моделью. В отличие от OpenAI, он оптимизирован под жесткие структуры системных подсказок и нативную передачу медиафайлов.
Подключаем OpenRouter. Зачем он? Где живет конфиг Claude Code?
OpenRouter - это один из самых известных агрегаторов моделей. В нем вы платите за каждый токен, и можно криптой. Разумеется, это намного дороже, чем подписка. Но вы получаете доступ к нескольким тысячам разных моделей. И вы можете сравнивать разные модели на одних и тех же промтах. Также вы можете использовать для разных задач дешевые и дорогие модели по необходимости. Помимо этого тут есть и бесплатные модели, у которых есть лимиты, но если вам нужно немного бесплатных токенов для ваших маленьких задач, то это прекрасный вариант.
Я, например, использую OpenRouter для автоматического перевода моих статей на этом сайте и генерации сео-полей и slug. Это встроено в движок сайта, который я, собственно, написал сам с нуля при помощи ИИ дней за пять, это более умная и молниеносно быстрая альтернатива Wordpress. Сейчас у меня тратится пару центов на каждое сохранение и перевод статьи на английский язык.
Здесь вы также можете найти модели, которые работают с космической скоростью 500-1000 токенов в секунду и которые умеют вызывать tools. Никакая подписка на Codex или Claude не даст вам такой скорости.
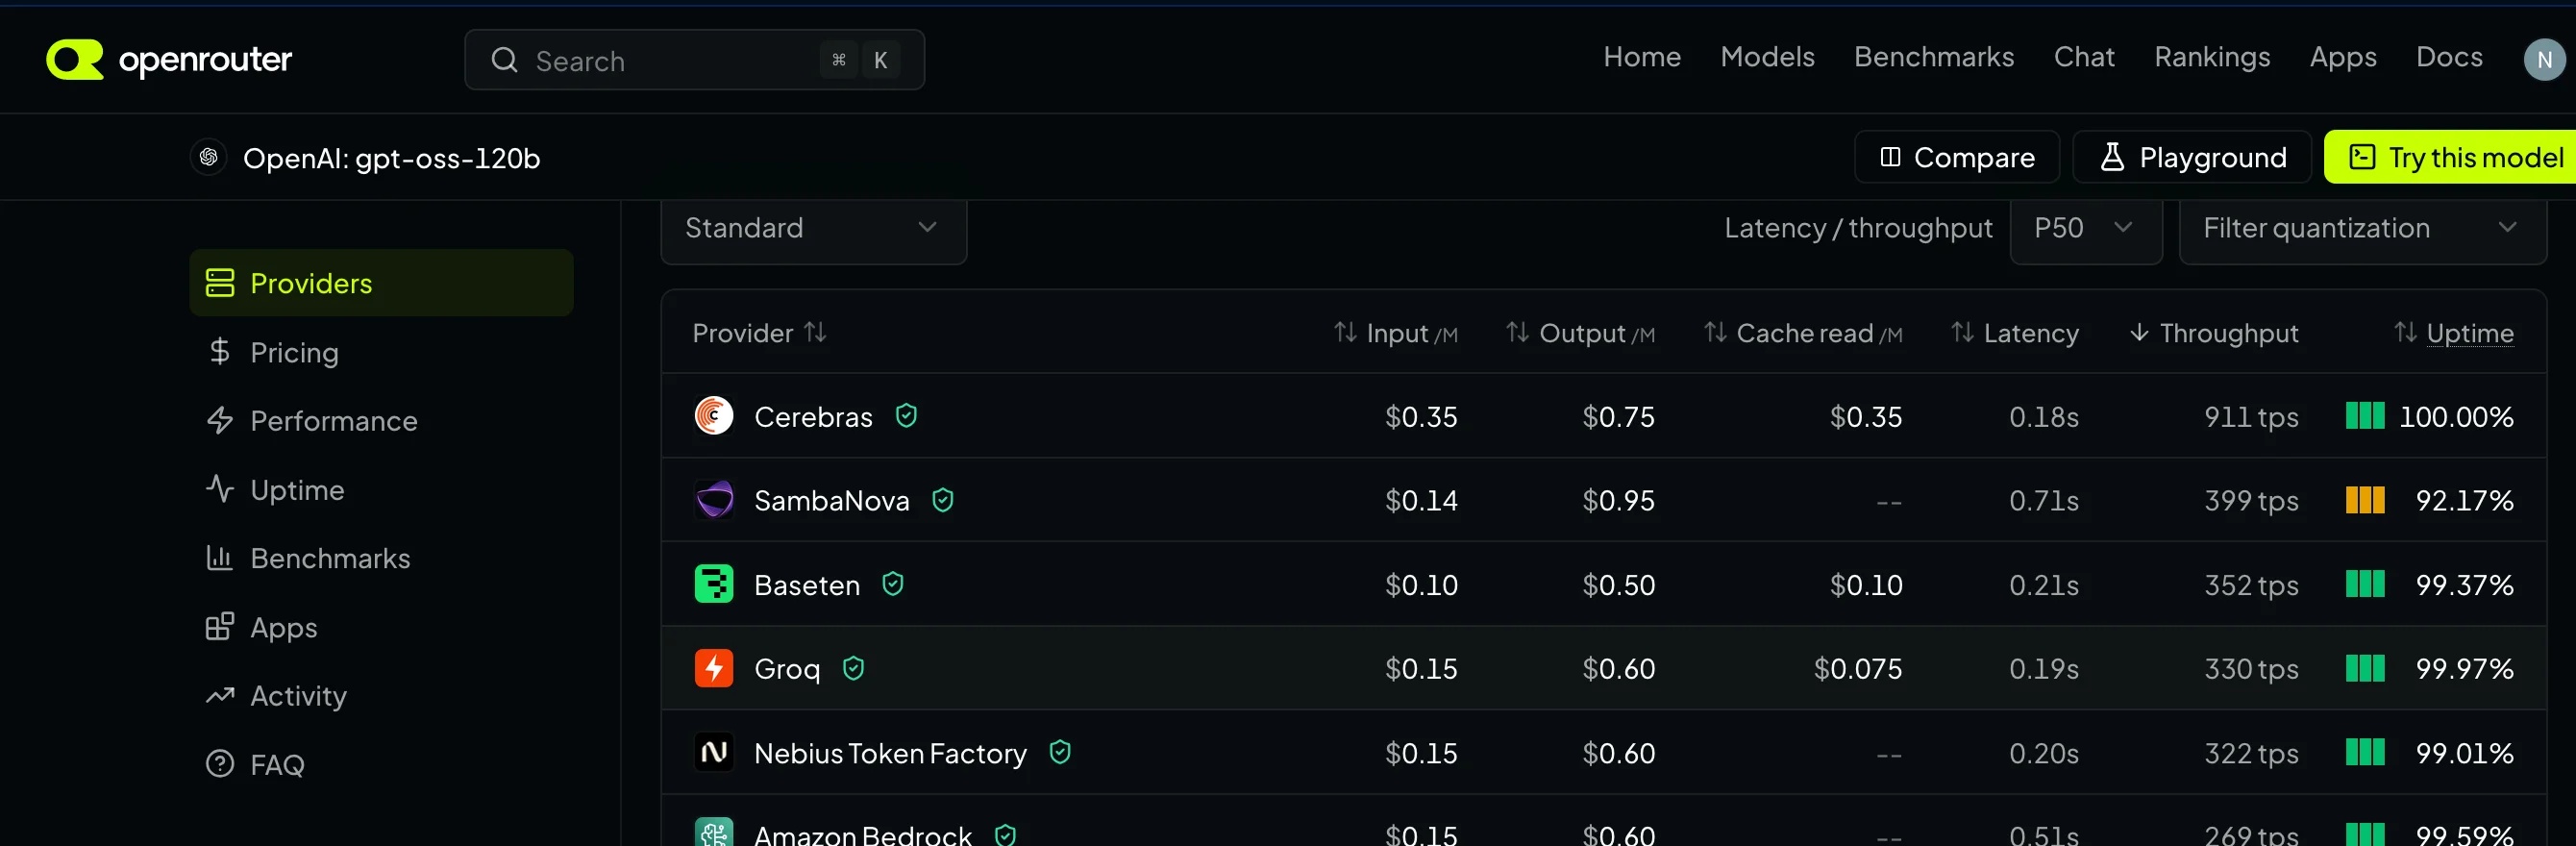
В качестве примера посмотрите на модель от OpenAI gpt-oss-120b у провайдера Cerebras. У провайдера есть свое хитрое железо, которое очень сильно ускоряет генерацию. Средняя скорость. - 911 токенов в секунду. Свое железо есть еще у Groq(крутые ребята, не путайте c Grok Илона Маска) - но там только 330 токенов в секунду для этой модели.
На скрине ниже смотрите колонку Throughput, там показывается, сколько токенов в секунду выдает модель.
Тестирование приложения через управление браузером при помощи Playwright превращается в какую-то невероятную сказку. В обычном режиме, руками проверить пошаговый сценарий для воспроизведения баги - в 10 раз быстрее, чем ждать, пока модель со скоростью 40-100 токенов в секунду будет переходить по страницам и делать снепшоты в поисках вашей баги.
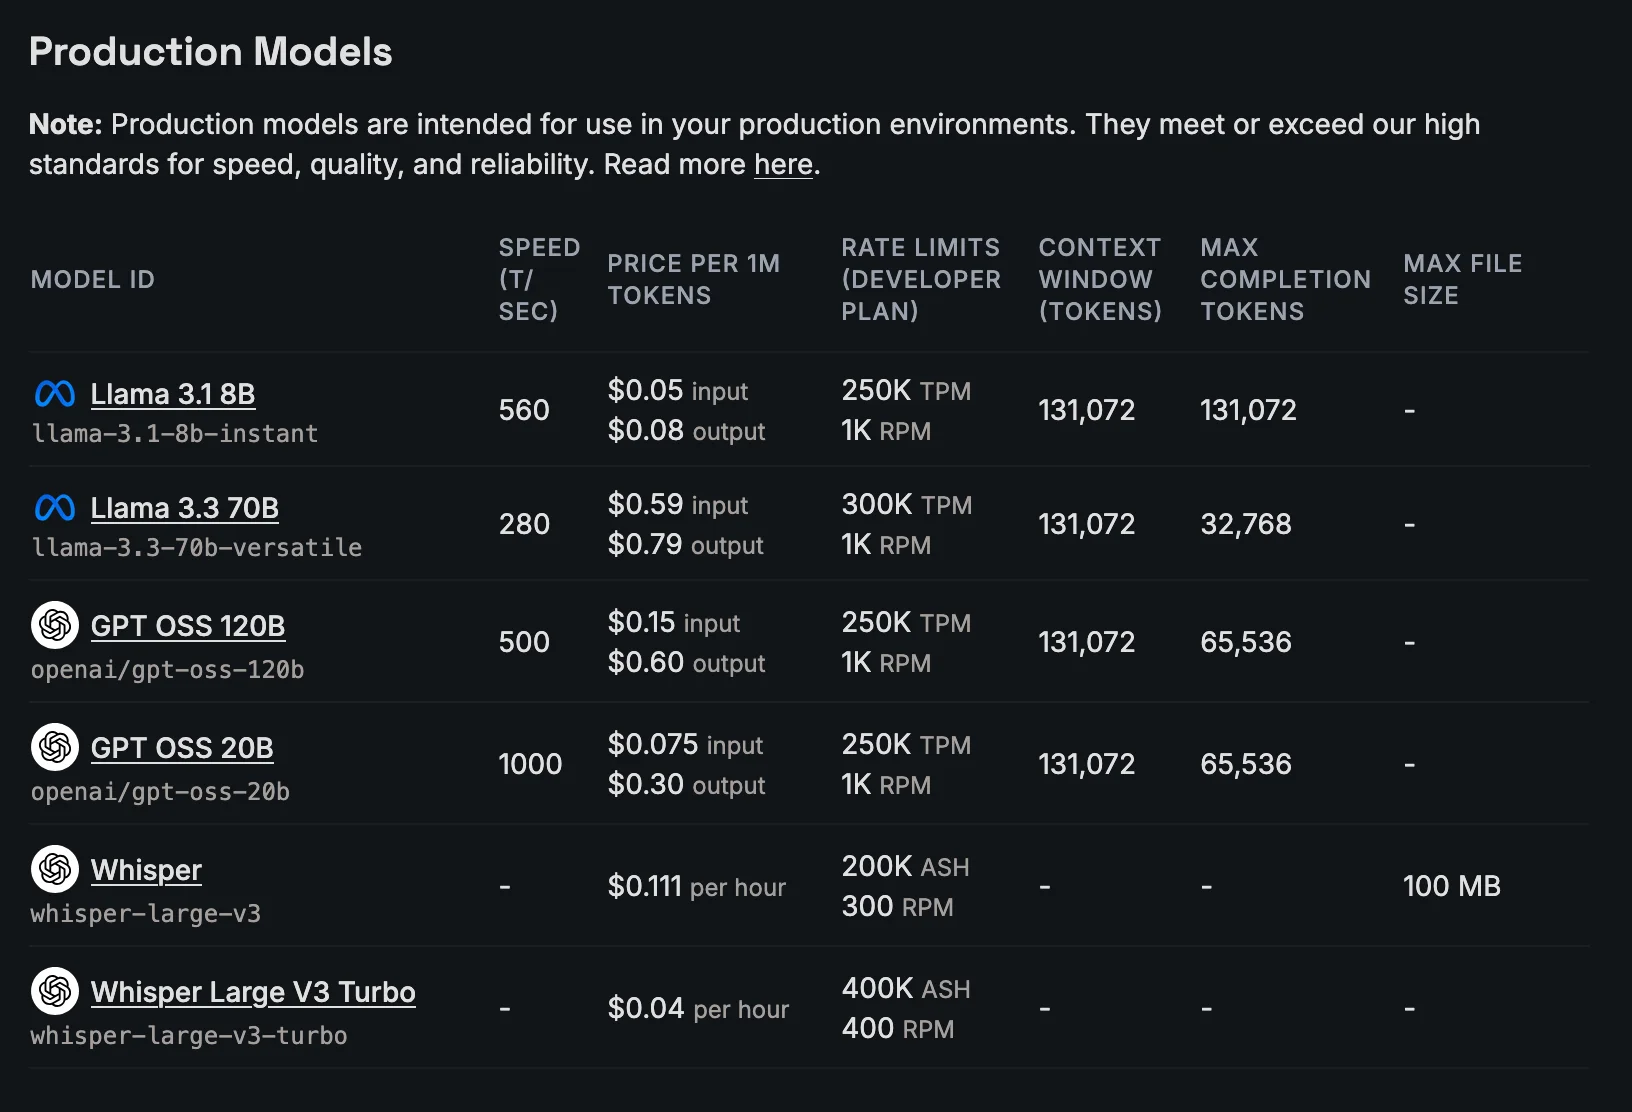
По поводу Groq - ребята обещают очень быстрый инференс до 1000 токенов в секунду на некоторых моделях.
Чтобы подключить другую модель - нам необходимо изменить URL, к которому модель будет обращаться. Также нужно будет переназначить все три модели который обычно используются по умолчанию(Sonnet, Opus, Haiku). В Claude Code для этого нам необходимо залезть в конфиг.
Конфиг модели находится в папке:
# Mac:
~/.claude/settings.json
Давайте сразу немного поменяем конфиг, чтобы это заработало с моделью Qwen 3.6 27B
{
  "env": {
    "ANTHROPIC_API_KEY": "",
    "ANTHROPIC_AUTH_TOKEN": "your_api_token",
    "ANTHROPIC_BASE_URL": "https://openrouter.ai/api",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "qwen/qwen3.6-27B",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "qwen/qwen3.6-27B",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "qwen/qwen3.6-27B",
    "API_TIMEOUT_MS": "600000",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": "1",
    "ENABLE_TOOL_SEARCH": "false",
    "MAX_THINKING_TOKENS": "32768",
    "MAX_MCP_OUTPUT_TOKENS": "65536",
    "CLAUDE_CODE_FILE_READ_MAX_OUTPUT_TOKENS": "65536",
    "CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS": "1",
    "CLAUDE_AUTOCOMPACT_PCT_OVERRIDE": "70",
    "CLAUDE_CODE_DISABLE_1M_CONTEXT": "1",
    "DISABLE_TELEMETRY": "1",
    "DISABLE_AUTOUPDATER": "1",
    "CLAUDE_CODE_ENABLE_GATEWAY_MODEL_DISCOVERY": "1"
  },
  "model": "opus"
}
Очень важно!
ANTHROPIC_API_KEYнужно сделать пустой строкой, чтобы Клод не стучался в облако Антропика.Добавьте ваш токен от OpenRouter в
ANTHROPIC_AUTH_TOKENДля Claude Code используйте именно
"ANTHROPIC_BASE_URL": "https://openrouter.ai/api",/api/v1- не подойдет, это OpenAI- совместимый эндпоинт - с клодом он работать не будет.
Подключаем модель OpenAI OSS-120B от самого быстрого провайдера Cerebras со скоростью 911 токенов/секунду через OpenRouter
Я хочу использовать не просто модель, а модель от самого быстрого провайдера Cerebras. Через конфиг это сделать нельзя. Поэтому мы используем обходной путь.
В OpenRouter есть такой механизм, который называется presets.
Он позволяет указать специфичный путь для модели и под капотом настроить все ее параметры, в том числе и указать конкретного провайдера.
Создаем новый пресет для кастомной модели под Claude Code
Заходим на страницу https://openrouter.ai/workspaces/default/presets
Нажимаем "New preset"
Вводим любое имя, например "Claude Cerebras"
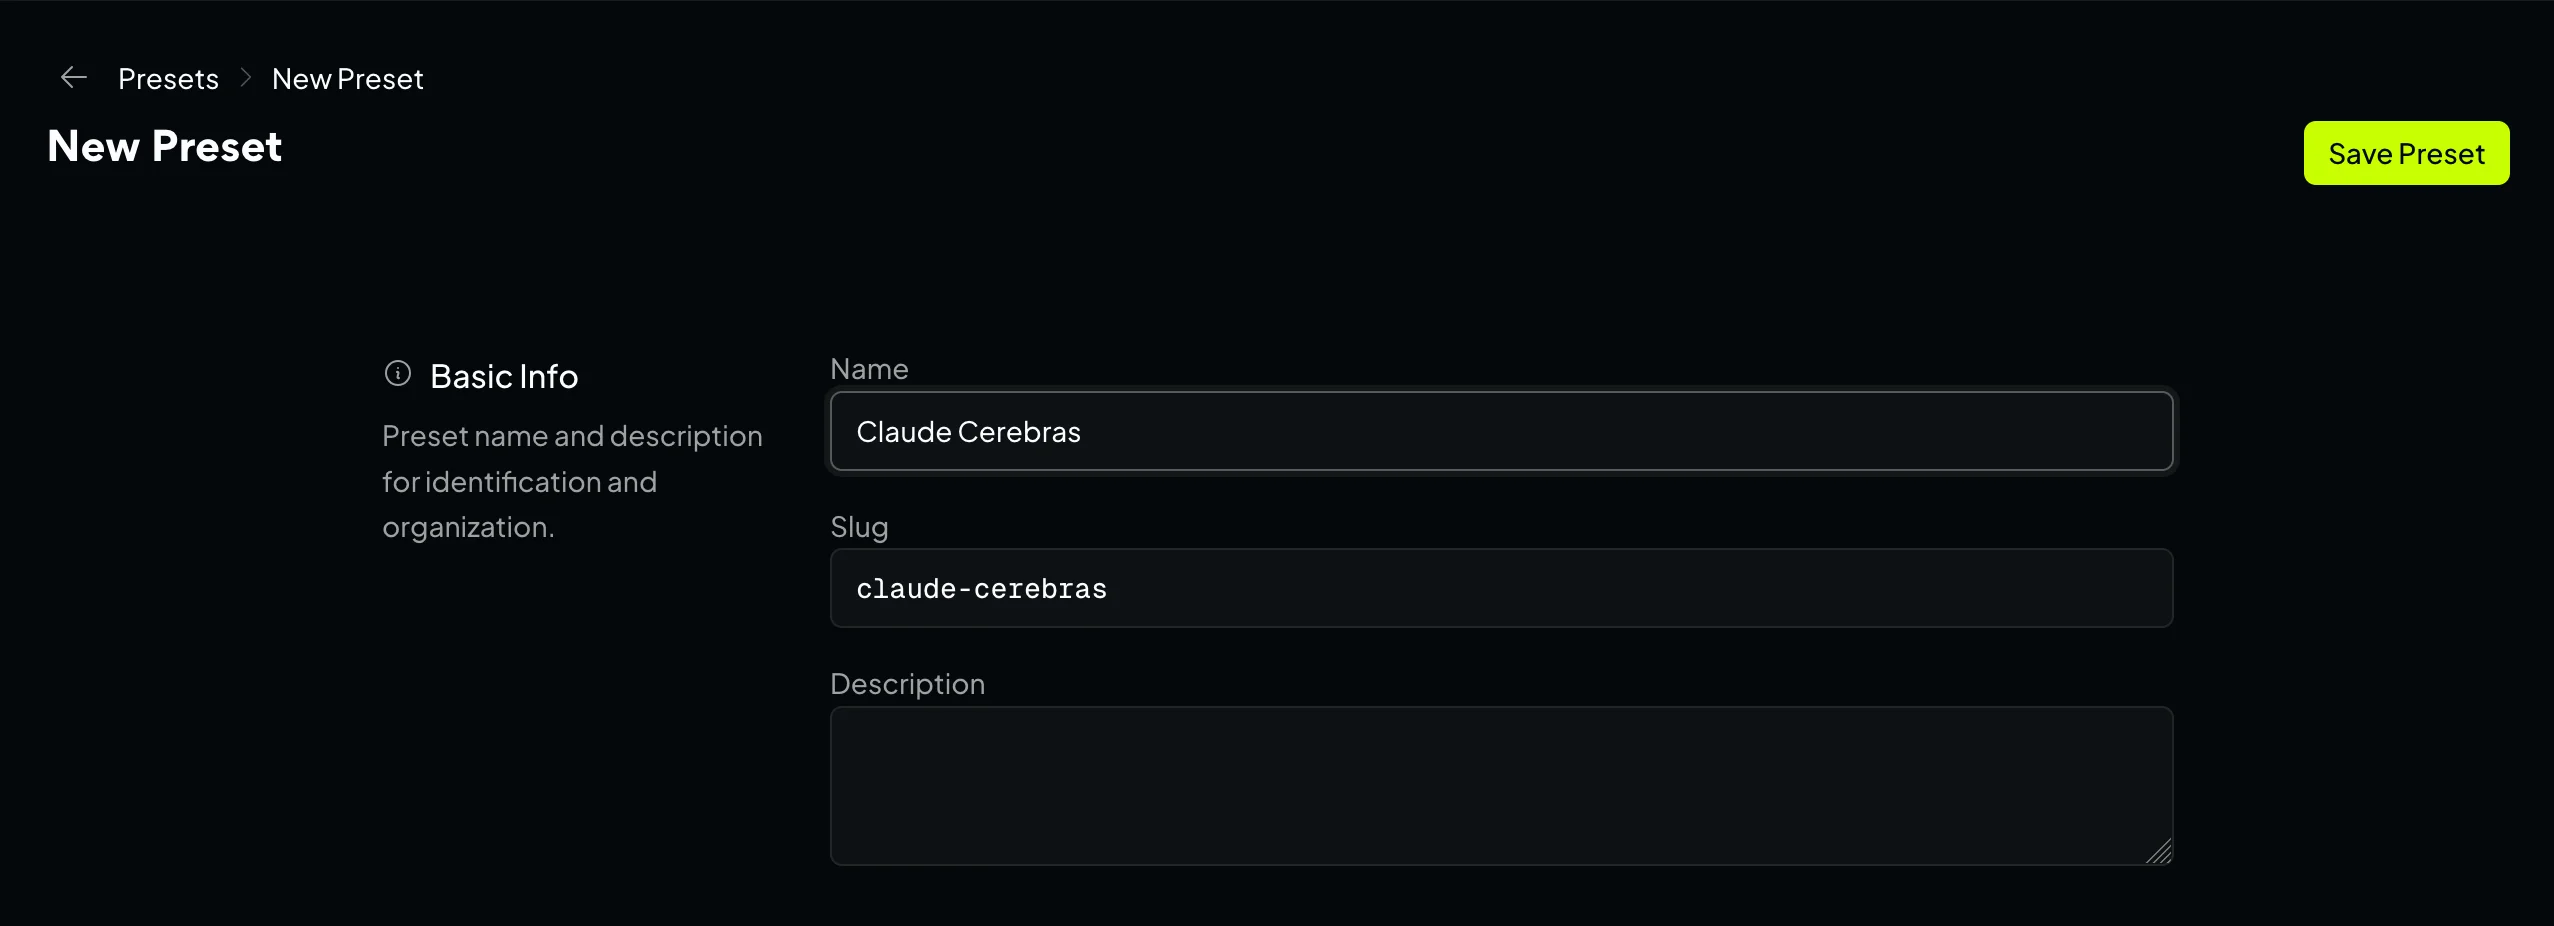
Находим раздел добавления модели.
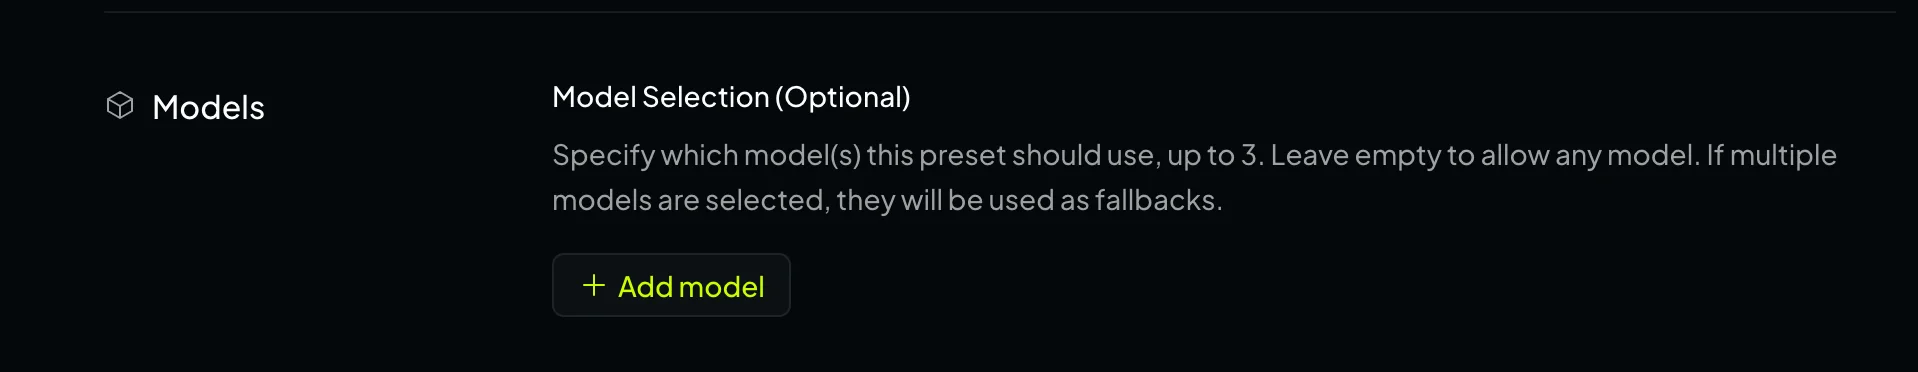
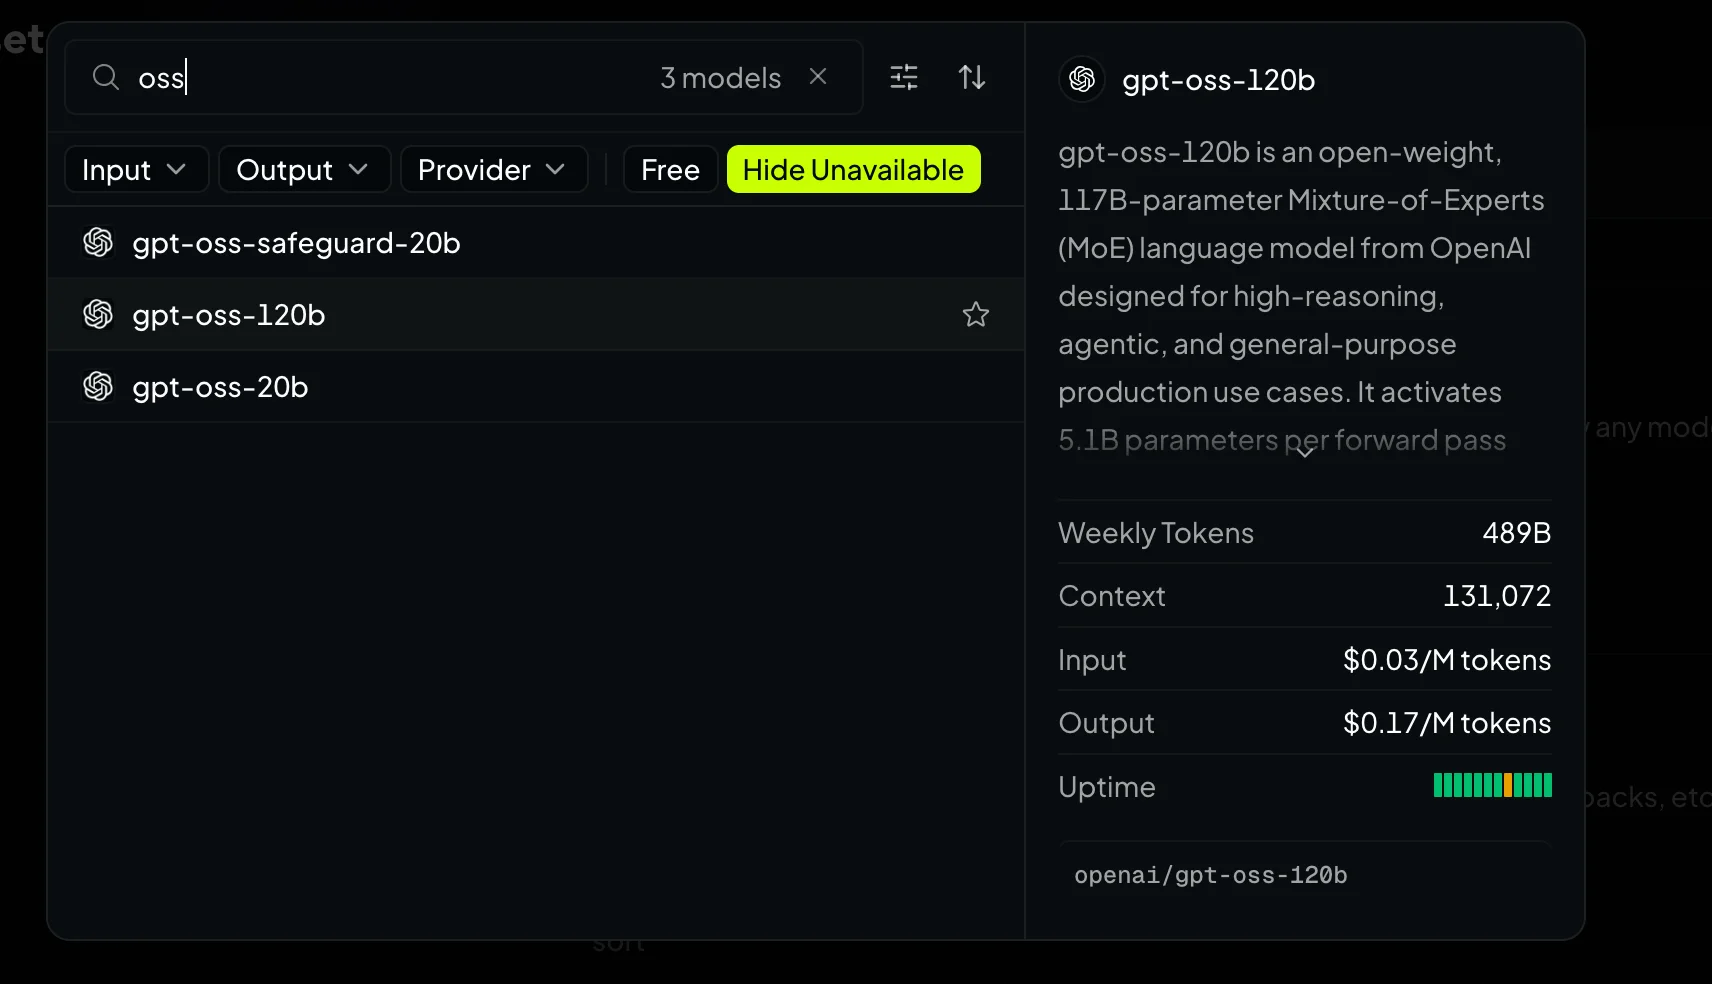
Нажимаем Add model и ищем oss 120b - добавляем ее
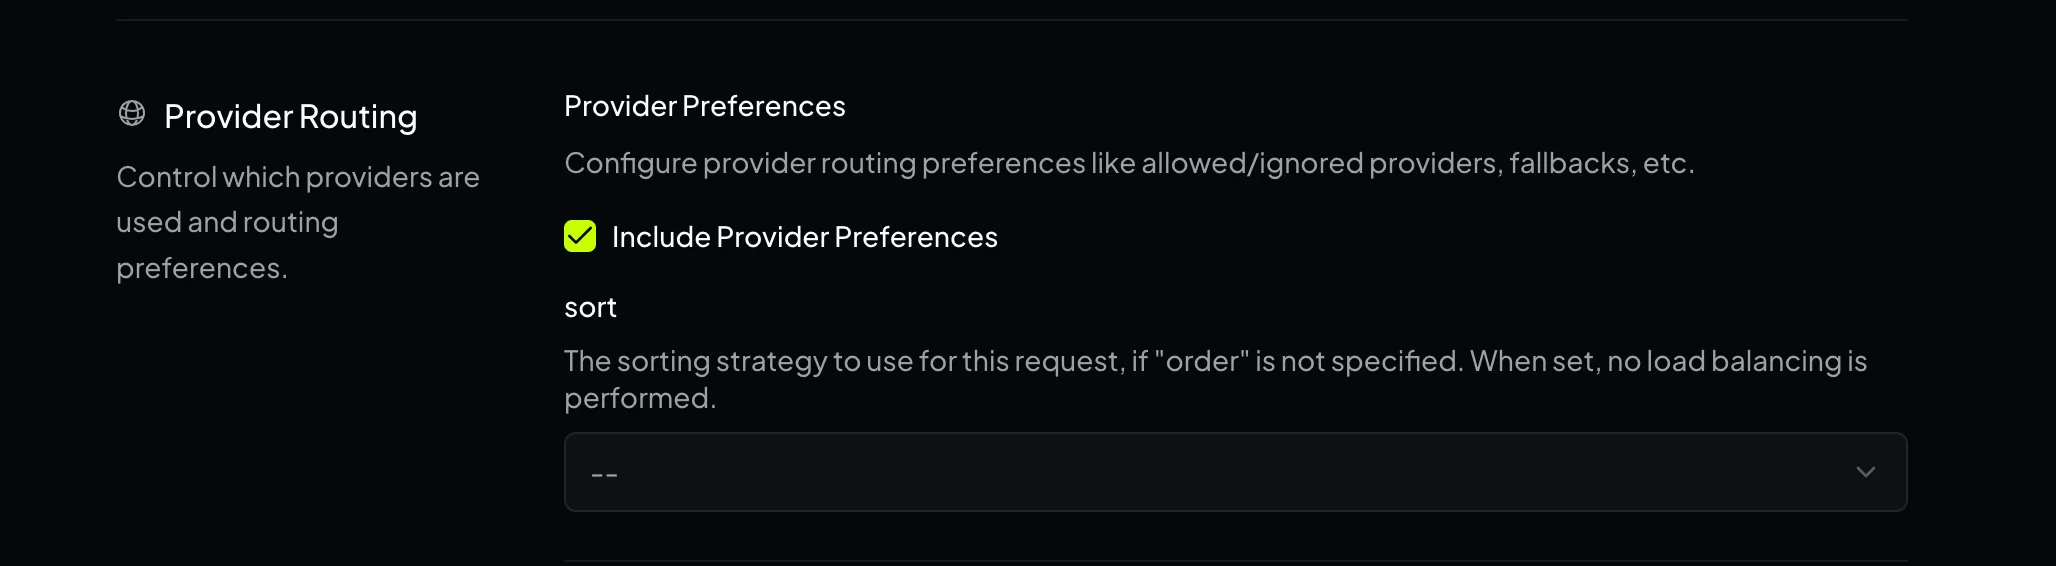
Листаем немного ниже и находим "Include Provider Preferences"
Листаем немного ниже и находим настройку Provider routing-> only - выбираем там провайдера Cerebras.
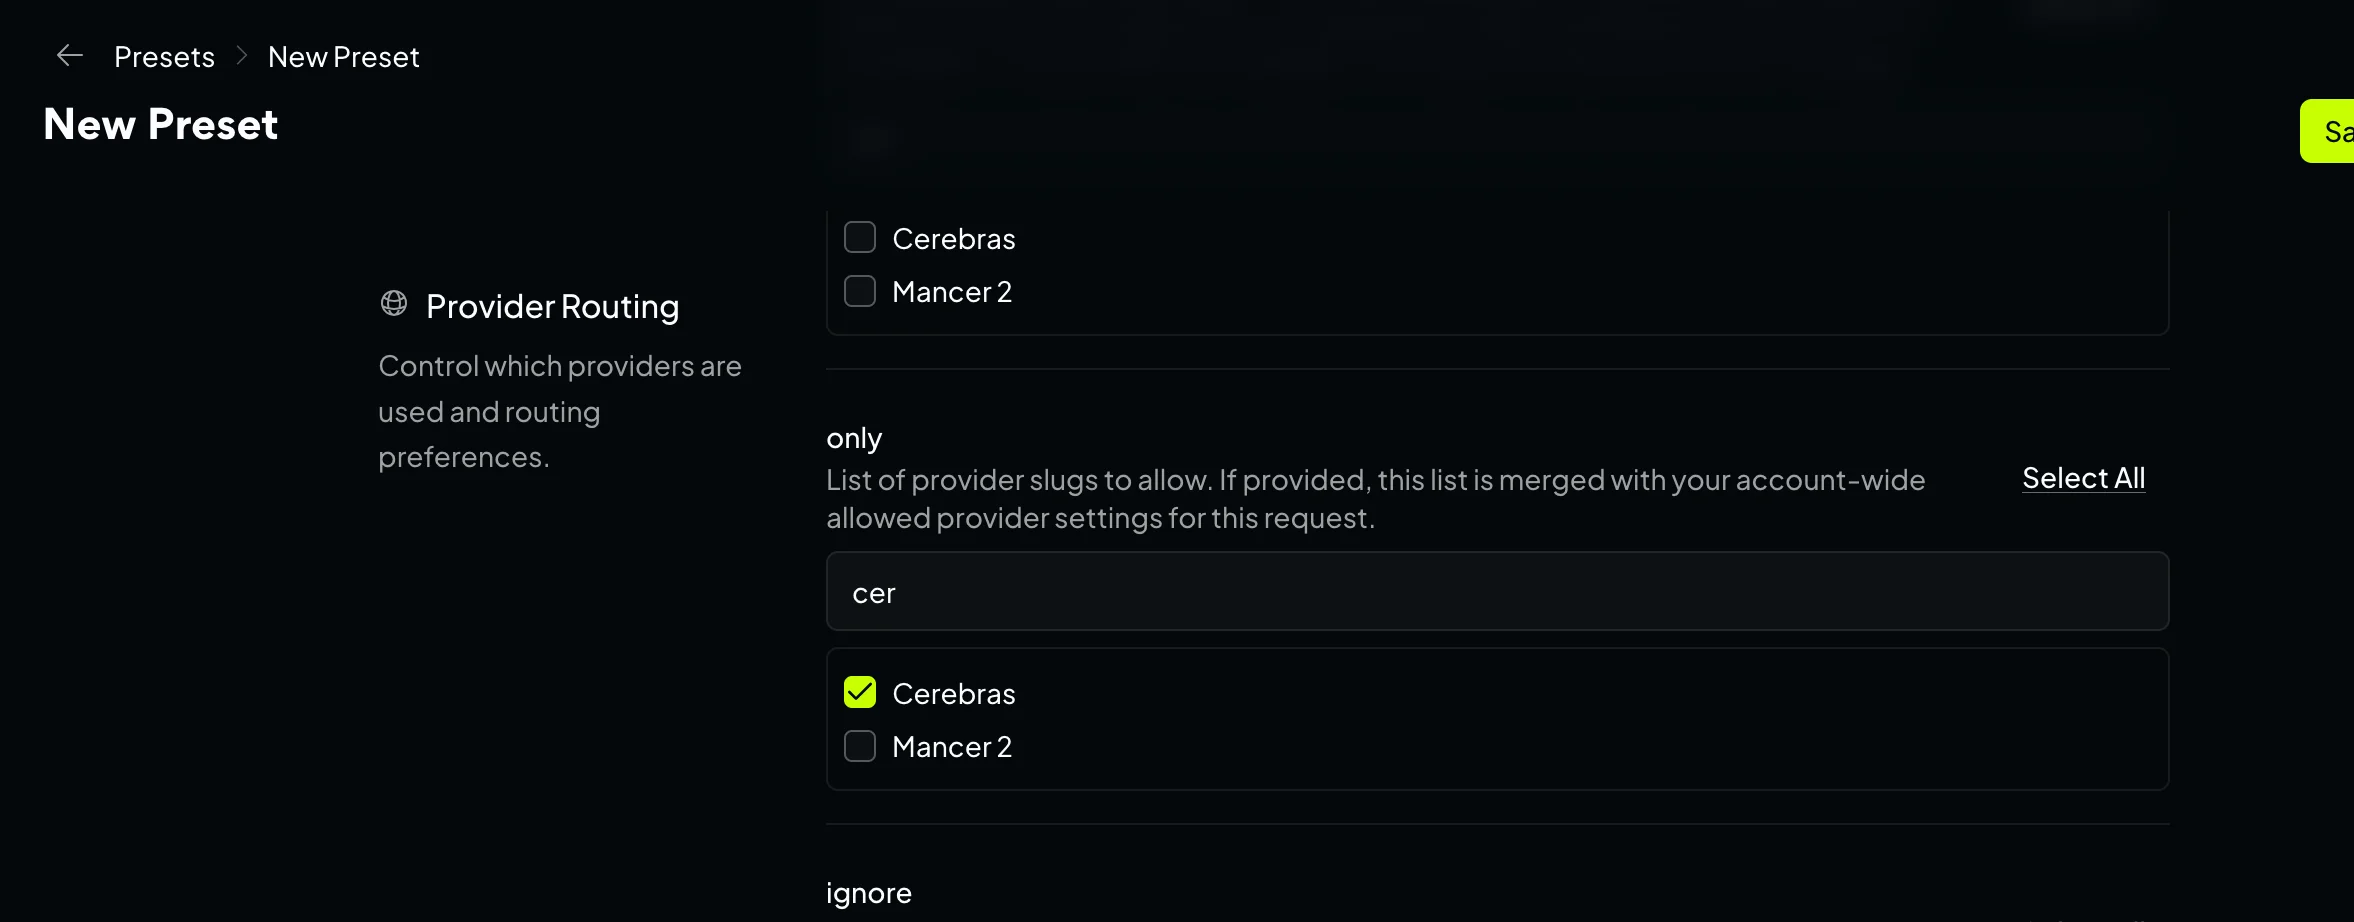
Сохраняем пресет нажатиме кнопки Save.
Теперь, когда любая программа или приложение, которое будет обращаться в оупен роутер к модели "@preset/claude-cerebras", будет автоматически перенаправляться на нашу настроенную модель.
Нам осталось столько поменять конфиг на новый.
{
  "env": {
    "ANTHROPIC_API_KEY": "",
    "ANTHROPIC_AUTH_TOKEN": "your_api_token",
    "ANTHROPIC_BASE_URL": "https://openrouter.ai/api",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "@preset/claude-cerebras",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "@preset/claude-cerebras",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "@preset/claude-cerebras",
    "API_TIMEOUT_MS": "600000",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": "1",
    "ENABLE_TOOL_SEARCH": "false",
    "MAX_THINKING_TOKENS": "32768",
    "MAX_MCP_OUTPUT_TOKENS": "65536",
    "CLAUDE_CODE_FILE_READ_MAX_OUTPUT_TOKENS": "65536",
    "CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS": "1",
    "CLAUDE_AUTOCOMPACT_PCT_OVERRIDE": "70",
    "CLAUDE_CODE_DISABLE_1M_CONTEXT": "1",
    "DISABLE_TELEMETRY": "1",
    "DISABLE_AUTOUPDATER": "1",
    "CLAUDE_CODE_ENABLE_GATEWAY_MODEL_DISCOVERY": "1"
  },
  "model": "opus"
}
Почти готово!
Выполните сначала команду разлогина на всякий случай.
claude /logout
claude
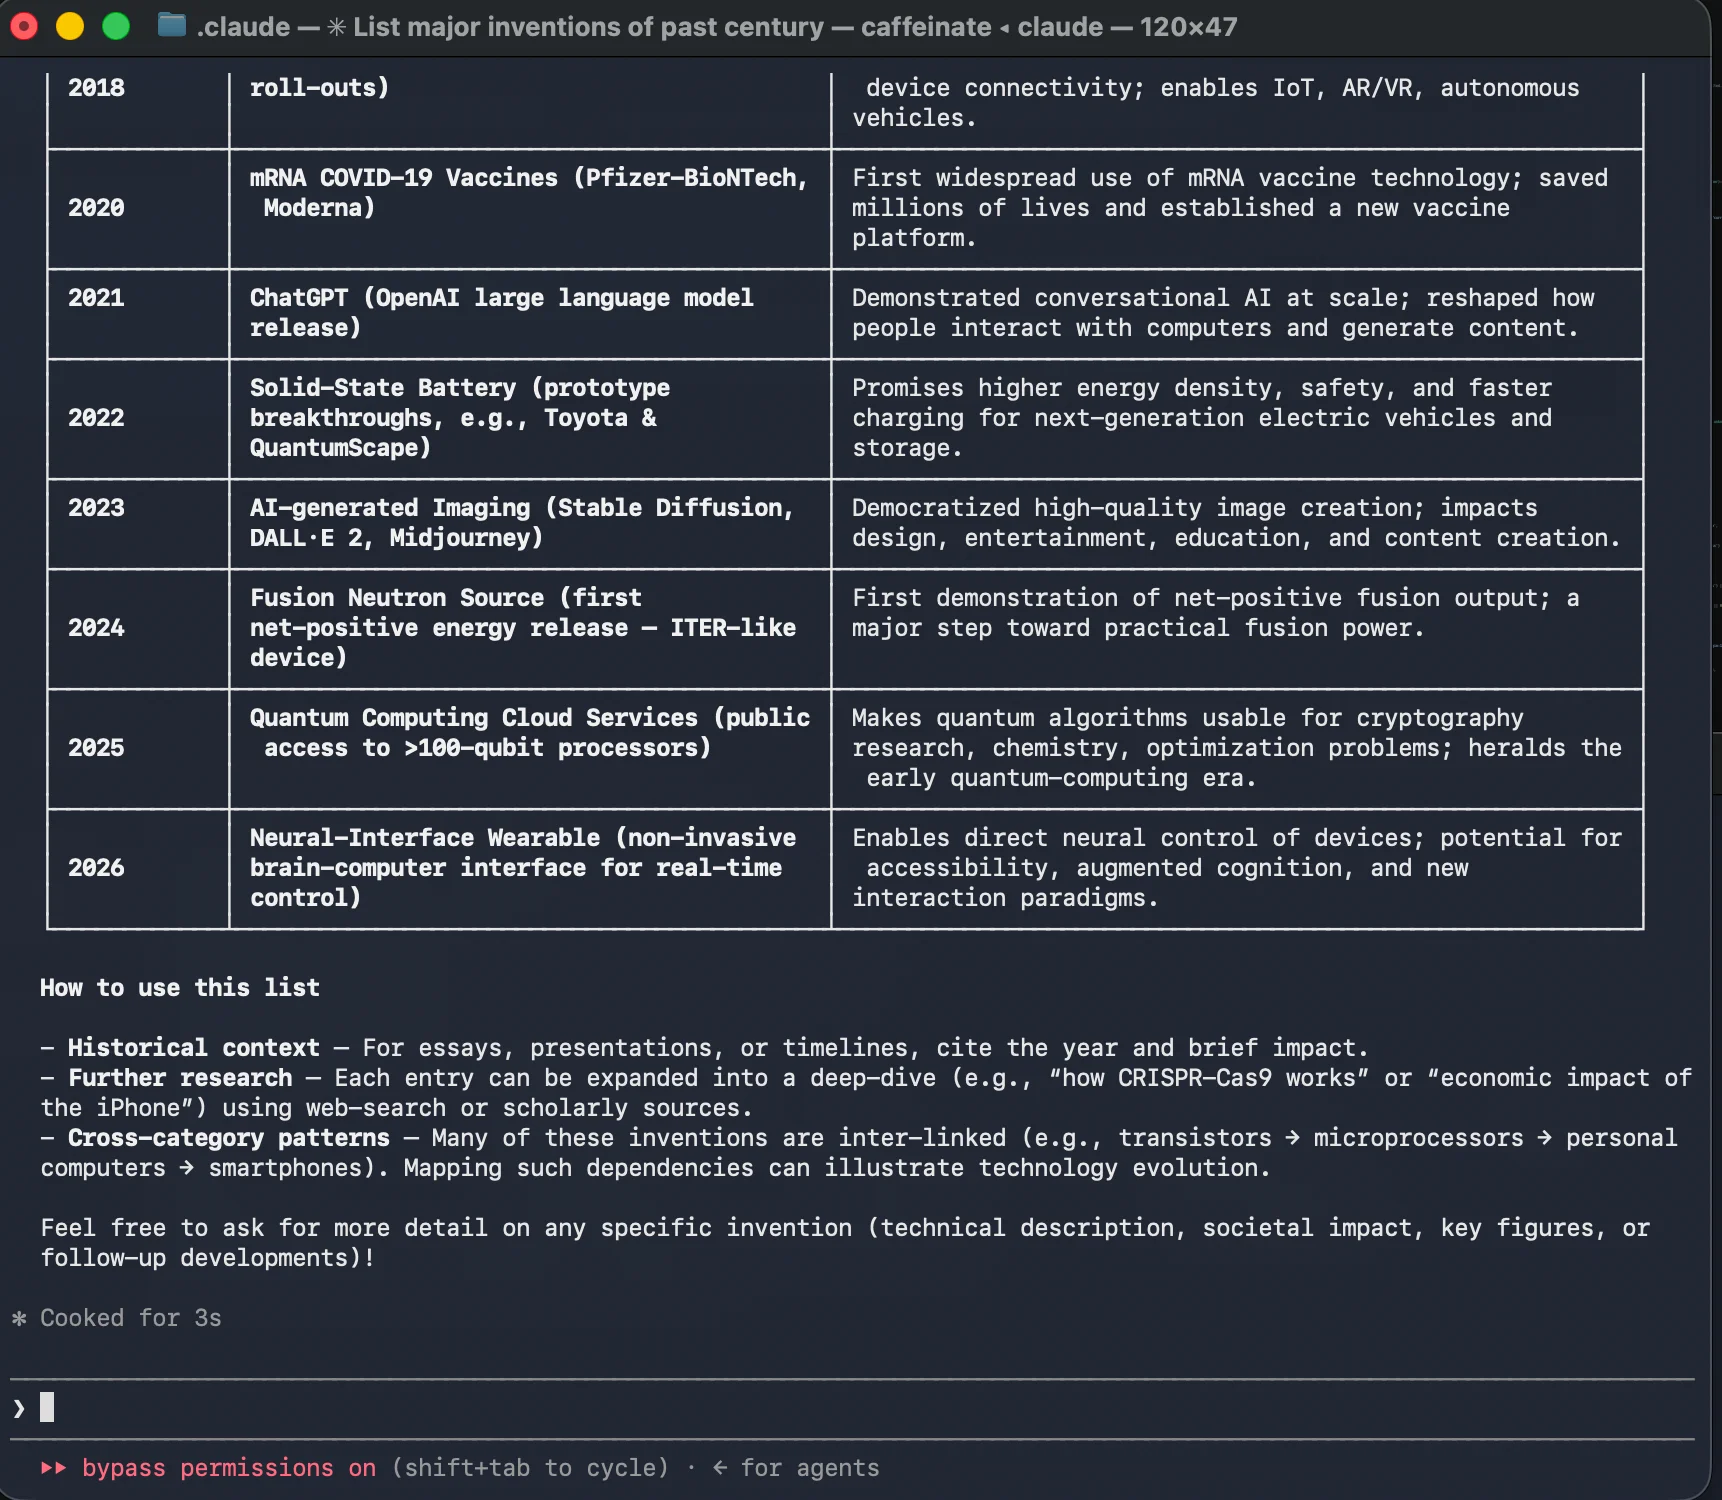
Я попросил сделать мне большую таблицу с самыми важными изобретениями за последние сто лет. Через три секунды все уже было готово.
Скорость невероятная!
Подключаем Claude Code к локальной LM Studio для 100% работы offline
LM Studio - это программа, которая позволяет очень удобно скачивать любые LLM-модели с HuggingFace и сразу их использовать в чате, который встроен в программу. Также из коробки доступен веб-сервер, который совместим с форматами OpenAi и Anthropic и к которому вы можете подключаться из любых программ, в том числе и Claude Code.
Пошаговая инструкция:
Качаем саму программу https://lmstudio.ai/, устанавливаем
В левом сайдбаре самая нижняя иконка отвечает за поиск модели.
Нажимаем на нее и у нас появится окно с поиском модели
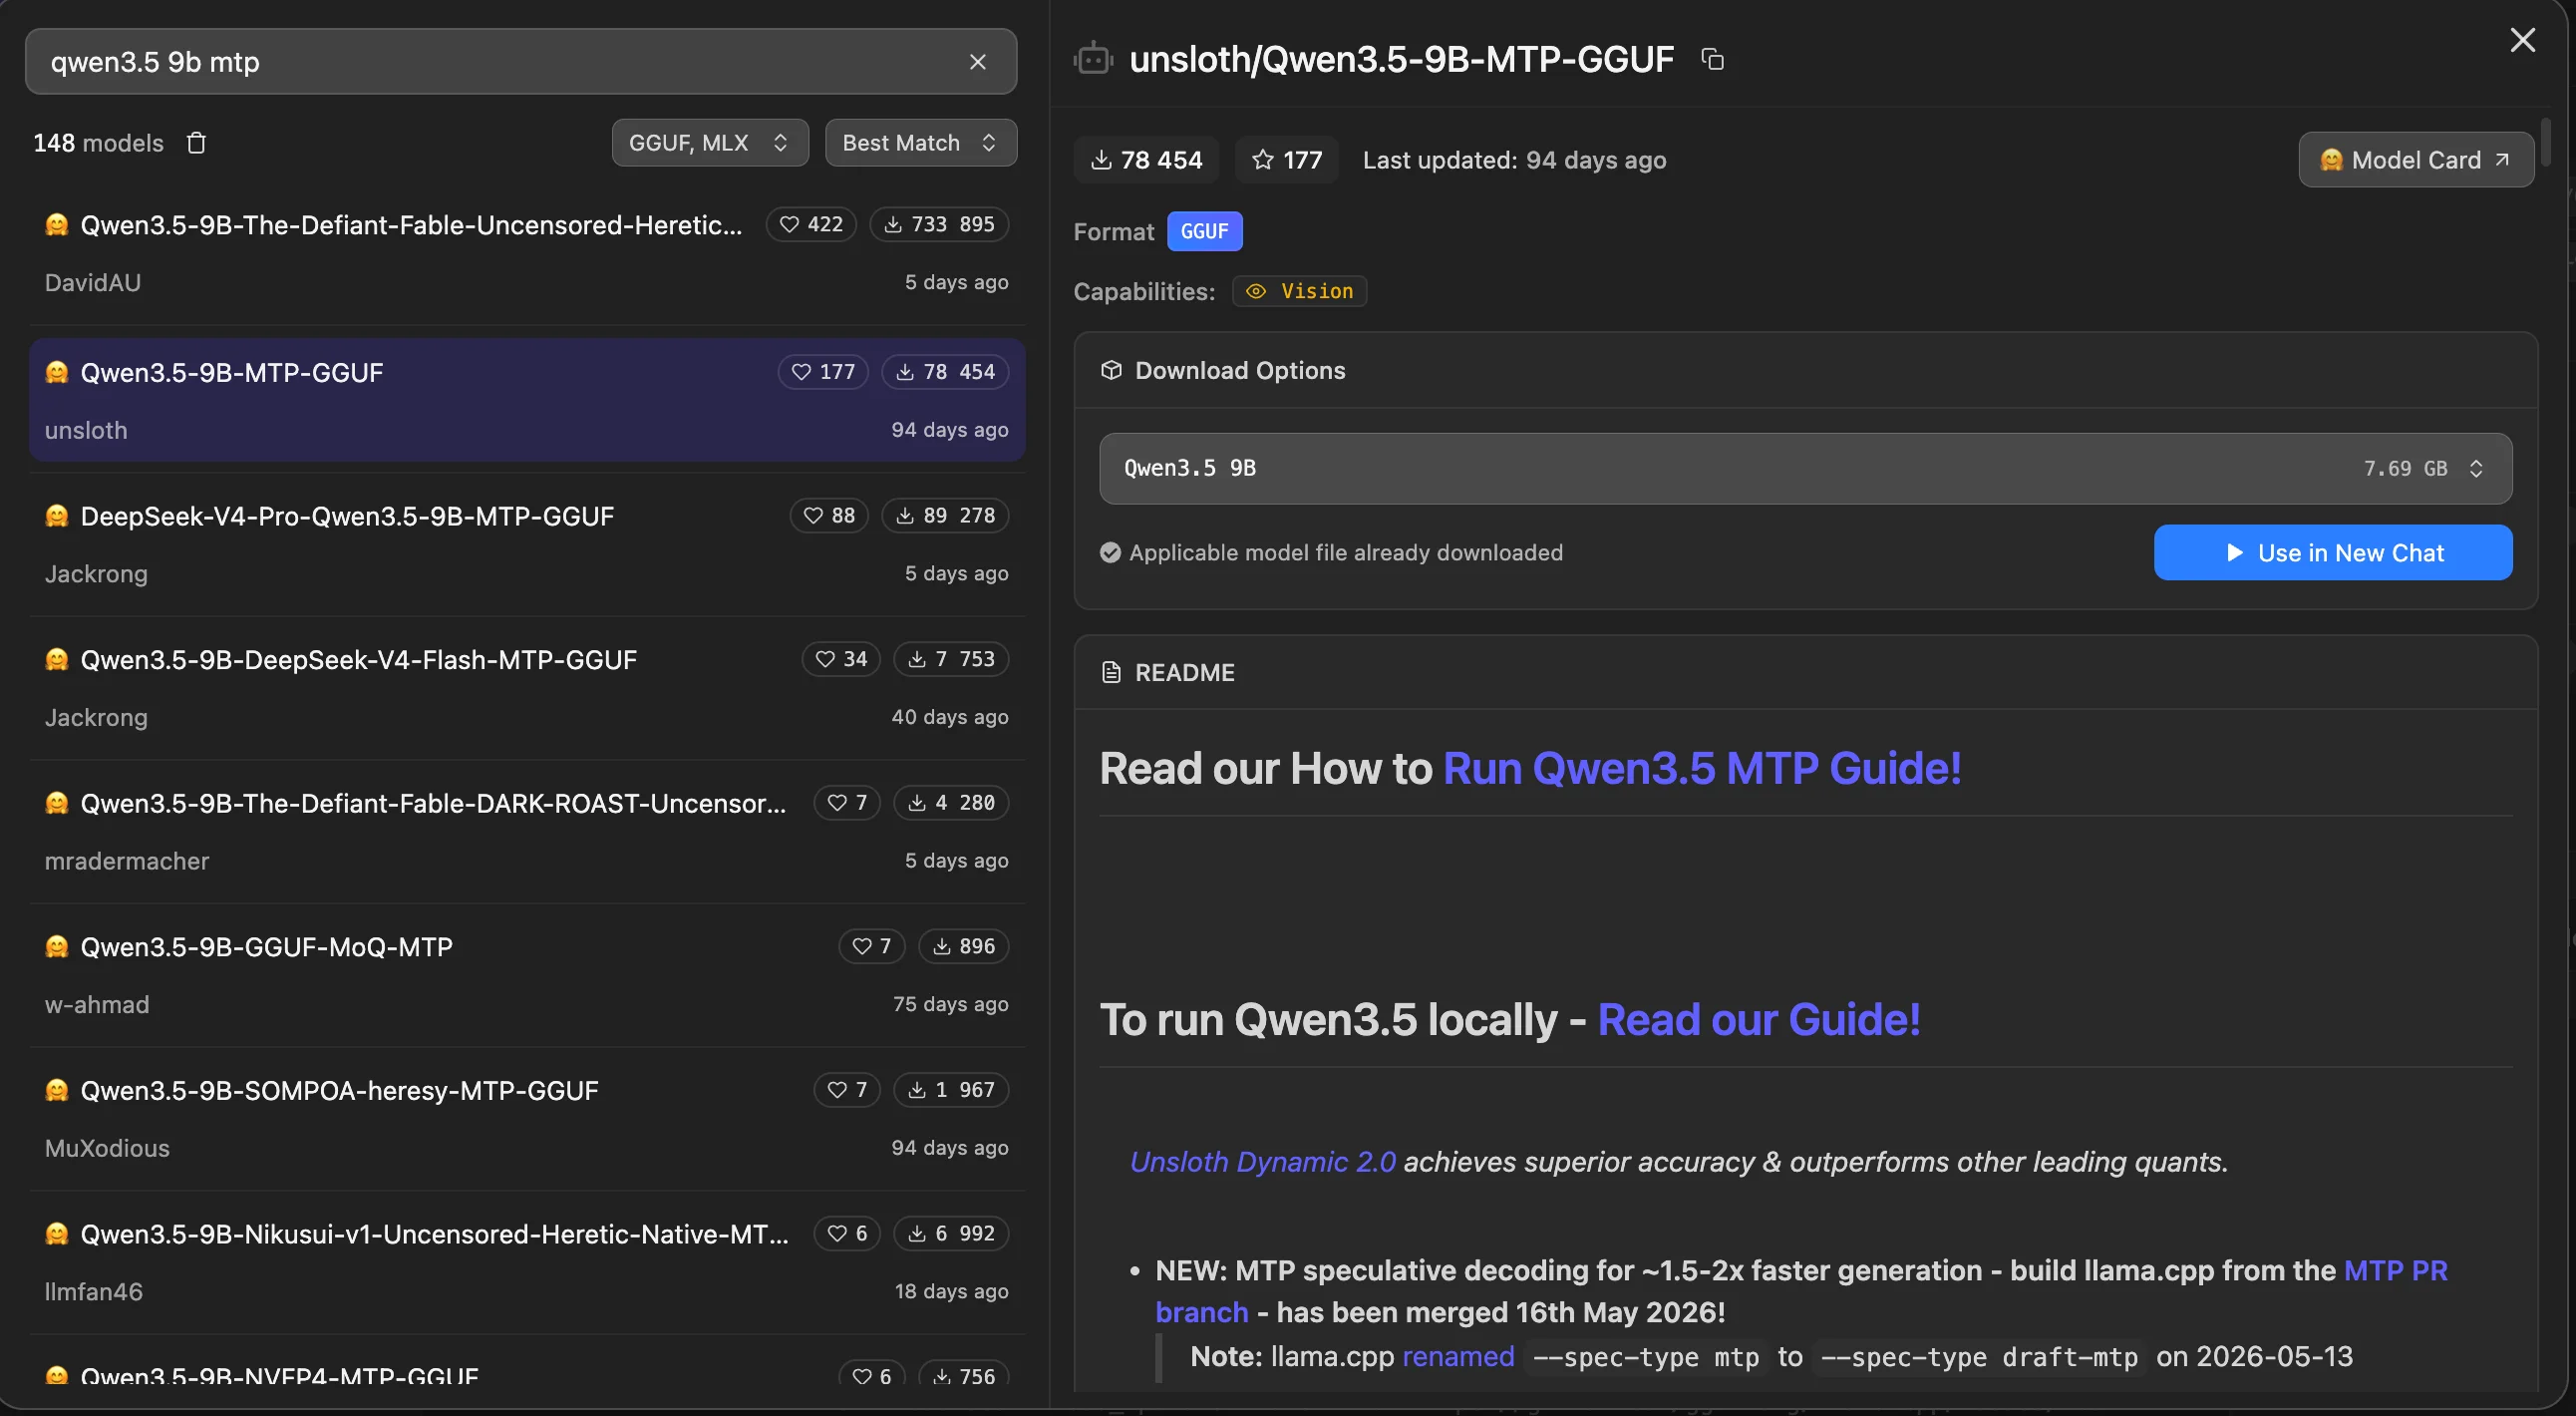
Например, я выбрал под ноутбук модель Qwen3.5-9B MTP - жмем кнопку Download. У меня она уже скачана.
Под Macbook лучше выбирать модели в формает MLX - они оптимизировано под процессоры Apple M1-M5.
После скачивания я загружаю модель при помощи кнопки Load model. Не забудьте увеличить контекст(Context Length) в настройках модели - по умолчанию там обычно 8192 токенов.
У меня модель поддерживает MTP для ускорения генерации и я его тоже включил.
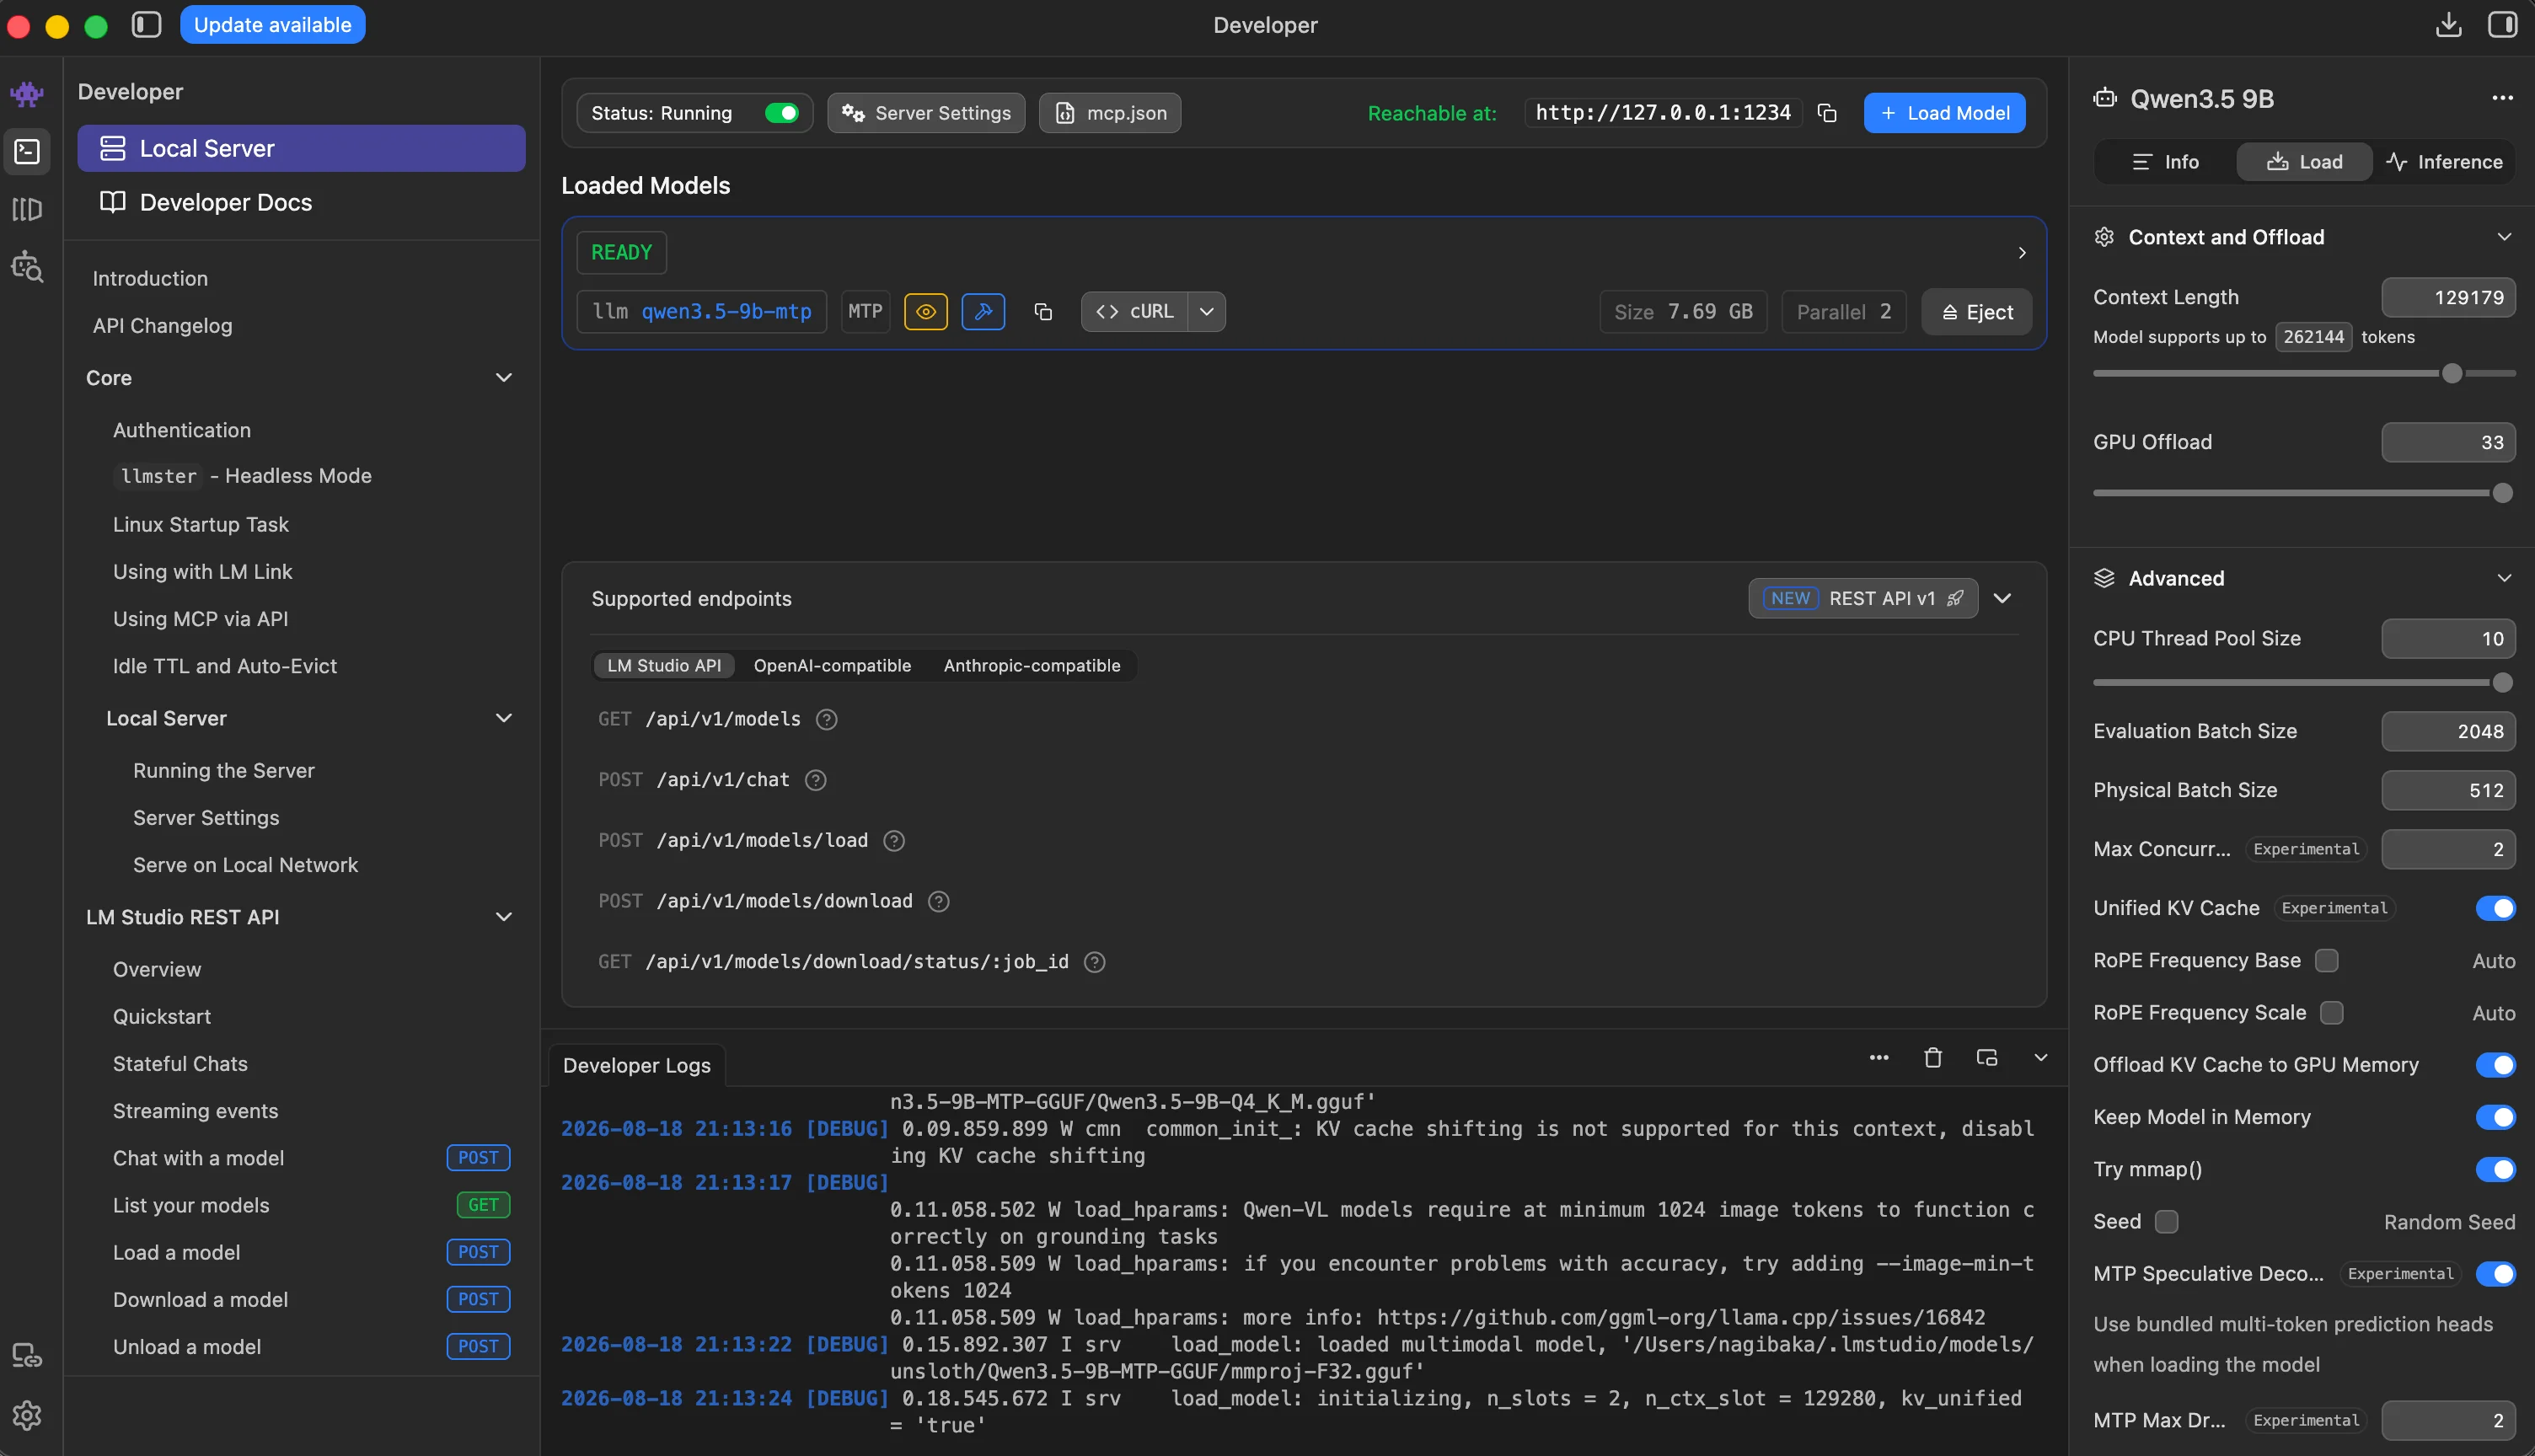
В самом верху есть переключатель для актиации веб-сервера и адрес по которому он будет доступен. Включите его.
И теперь эта модель доступна для всех приложений локально по локальному адресу:
Авторизация не нужна, поэтому поле для ключа в других приложений можно заполнять чем угодно или оставлять пустым.
Осталось поменять конфиг:
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "test",
    "ANTHROPIC_BASE_URL": "http://127.0.0.1:1234",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "qwen3.5-9b-mtp",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "qwen3.5-9b-mtp",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "qwen3.5-9b-mtp",
    "API_TIMEOUT_MS": "600000",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": "1",
    "ENABLE_TOOL_SEARCH": "false",
    "MAX_THINKING_TOKENS": "32768",
    "MAX_MCP_OUTPUT_TOKENS": "65536",
    "CLAUDE_CODE_FILE_READ_MAX_OUTPUT_TOKENS": "65536",
    "CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS": "1",
    "CLAUDE_AUTOCOMPACT_PCT_OVERRIDE": "70",
    "CLAUDE_CODE_DISABLE_1M_CONTEXT": "1",
    "DISABLE_TELEMETRY": "1",
    "DISABLE_AUTOUPDATER": "1"
  },
  "model": "sonnet",
  "skipDangerousModePermissionPrompt": true,
  "theme": "dark"
}
Запускаем Claude Code и вуаля!
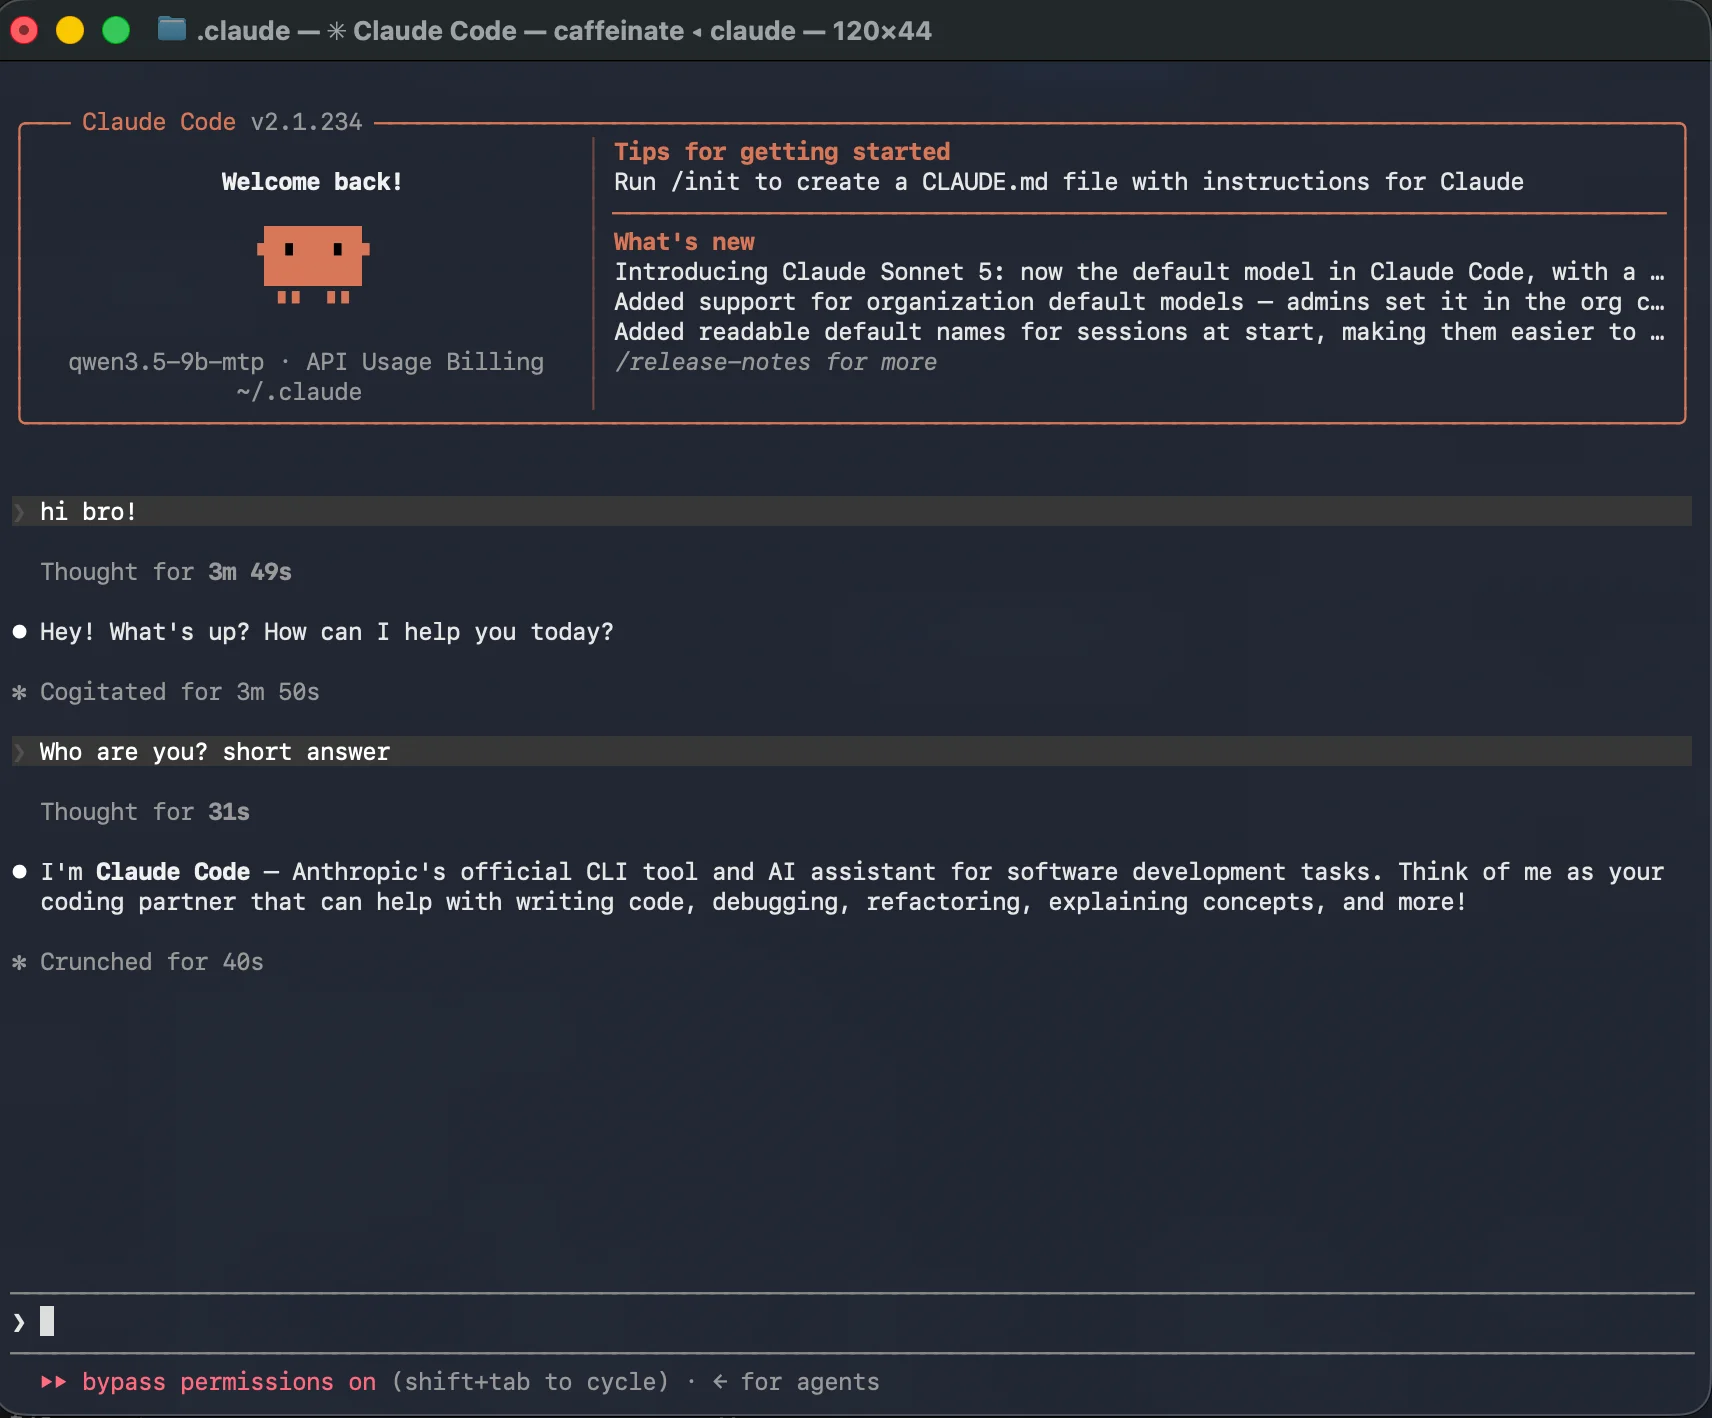
Почему ответ почти 4 минуты шел?
Больше всего времени ушло на обработку входного запроса. У Claude Code большой системный промпт. Обратите внимание, что на мой следующий вопрос ушло 40 секунд. Это наглядно показывает, как работает кеширование. Первый большой запрос закешировался и последующие ответы выдаются быстрее.
На ноутбуке скорость 8-15 токенов в секунду. Это немного и недостаточно для комфортной работы. На видеокарте будет в 10+ раз быстрее.
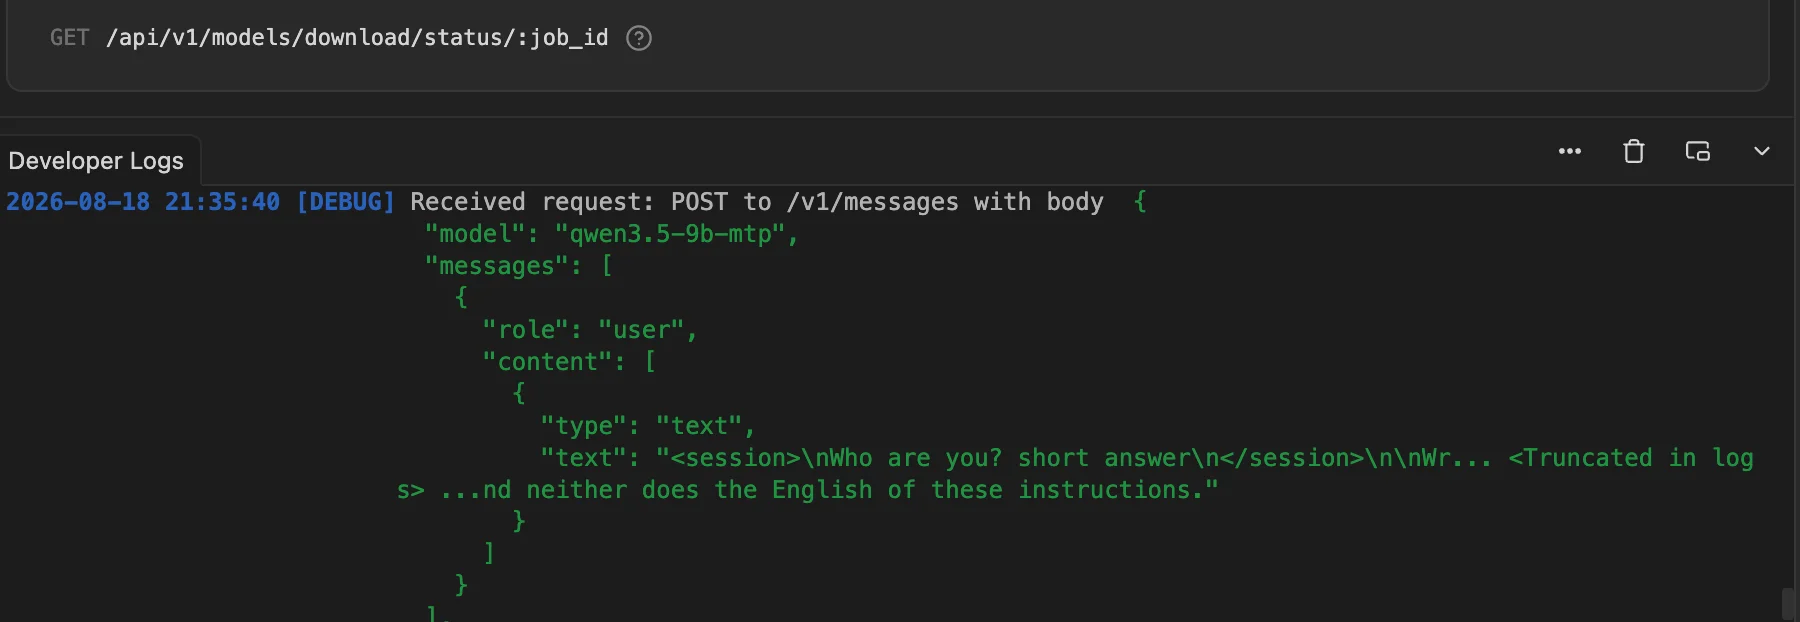
И кстати, в логах LM Studio прямо в интерфейсе вы можете посмотреть полностью весь системный промт Claude Code и все что отправлялось в LLM.
Настройка корпоративных моделей
Как правило, инструкция выдается в компании. Но суть примерно та же. Вы при помощи скрипта или руками меняете адрес модели, вставляете выданный вам токен, и можно работать!
На этом всё!