
Урок
1.5 Зачем под каждую задачу делать новую сессию? Как устроен кэш и контекст
В этом уроке я хочу разобрать основу основ работы с контекстом и кэшем. Эти вещи просто необходимо знать, чтобы эффективно взаимодействовать с LLM. Понимание контекста даст вам возможность c хирургической точностью формулировать задачу. А понимание кэша поможет вам не разориться при работе или если вы захотите написать своего собственного ИИ-агента.
Что обитает в контексте?
Контекст - это всё то, что мы отправляем в нейронную сеть каждый раз, когда нажимаем Энтер. Думаю, самый наглядный способ это показать на примере небольшого скрипта на NodeJS и сервиса, который логирует каждое обращение к LLM и показывает, сколько токенов было потрачено на вход и выход.
Для этого я использую свой аккаунт на Openrouter. Там есть бесплатные модели и если вы захотите все это дело повторить, то можете использовать их https://openrouter.ai/openrouter/free.
И вот код, который я буду запускать.
Пример на NodeJS для OpenRouter:
import OpenAI from "openai";

// Init OpenRouter
const client = new OpenAI({
  baseURL: "https://openrouter.ai/api/v1",
  apiKey: 'sk-api-key', // Your API-key from OpenRouter
});

// API call
const apiResponse = await client.chat.completions.create({
  model: 'openrouter/free',
  messages: [
    {
      role: "system",
      content: "You - AI-assistant. Ask very shortly."
    },
    {
      role: "user",
      content: "Hello! Wassup, bro?"
    }
  ],
});

// Extract the assistant message with reasoning_details
const response = apiResponse.choices[0].message.content;

console.log(response);
Что у нас тут происходит?
Мы отправляем системный промпт и наше сообщение для LLM - это входные токены.
После этого мы получили ответ от LLM, который вывелся в консоль. Это выходные токены.
Вот такой ответ я получил.

А вот сколько токенов я потратил на вход и на выход: 38 + 86 = 124 токена. Очень бюджетно.

То есть, с каждым вашим сообщением вся история диалога отправляется в LLM. Может показаться, что с каждым сообщением мы будем тратить все больше и больше токенов, отправляя весь диалог заново. И можно ожидать астрономические счета. Но это не так. Для решения этой проблемы и было внедрено кэширование. О нем мы поговорим чуть позже.
Абсолютно таким же образом работает и в сложных системах, в том числе и в Claude Code. Разница лишь в том, что когда вы пишете одно сообщение, в контекст подмешивается большое количество дополнительной информации и контекста. И это не сто токенов, а обычно несколько тысяч.
А что происходит, когда вы пишете "Привет" вашему Claude Code?
Чтобы это наглядно увидеть, есть даже специальная команда. Вы можете ее сами ввести в Claude Code и посмотреть, что она выведет.
/context Вот кусочек вывода, далее там подробно расписано, на что расходуется контекст.
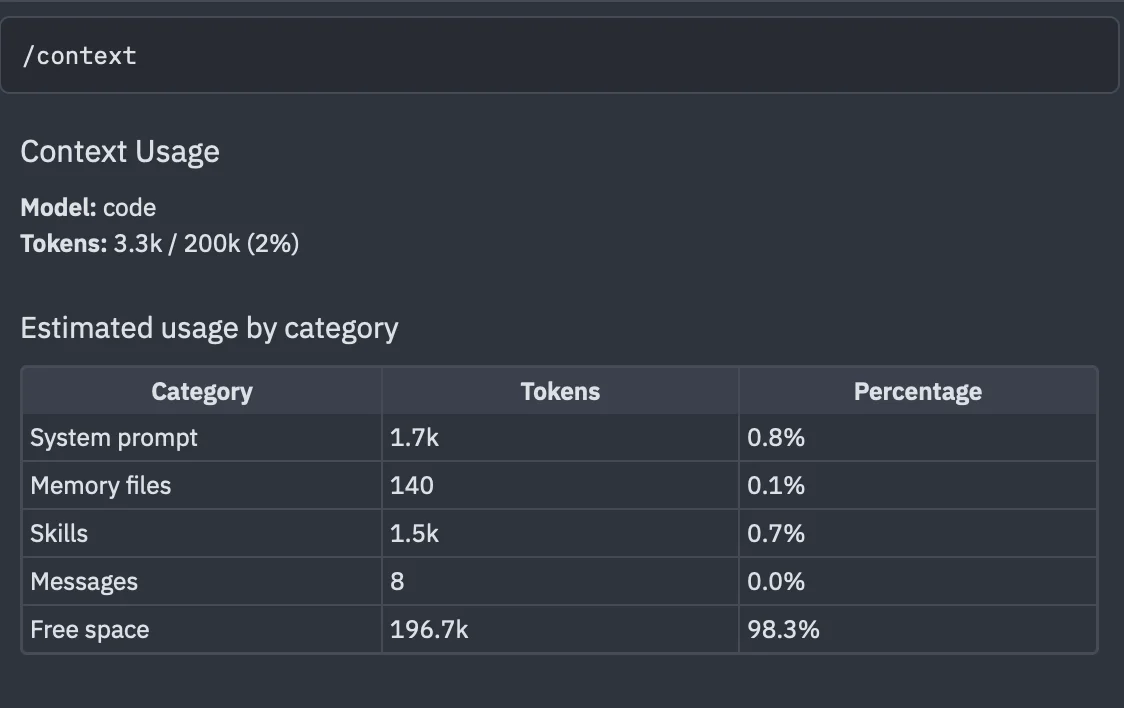
3300 токенов потратили на простой "Привет!".
Что попадает в контекст Claude Code, когда вы ему просто пишете "Привет!":
Жирный системный промт с описанием правил поведения, инструментов командной строки и многое другое.
ОС и имя пользователя, часовой пояс
Текущая директория и структура папок проекта до определенной глубины
Git статус, список измененных файлов, текущая ветка
CLAUDE.mdи.claude/rules/*.mdМета-информация от всех скиллов(не полностью содержимое файла скилла, а его описание из начала файла)
Схемы подключения MCP-серверов и описание всех доступных Tools
Автоматическая память Claude Code
Все содержимое чата, ваши сообщения и сообщения от нейронной сети.
Системный промт и оглавление скиллов - обычно занимают больше всего контекста. Но они кэшируются и лишние токены тратятся на них только в самом начале.
Как работает кэш на стороне LLM-провайдера
Когда вы отправляете свой запрос LLM-провайдеру, он использует кэширование контекста. Основная суть в том, чтобы не перерабатывать заново огромное количество текста при помощи GPU, а переиспользовать уже рассчитанные математические веса.
В кэш сохраняется не сам текст запроса, а KV-кэш (Key-Value Cache) - это промежуточные математические матрицы (ключи и значения), которые генерируются механизмом внимания (Attention) нейросети при обработке токенов.
Для проверки совпадений используется префиксное хэширование (Prefix Hashing):
Провайдер разбивает ваш промпт на токены.
Система создает цифровой отпечаток (хэш) для начальной части текста (префикса).
Чтобы произошло попадание в кэш (Cache Hit), начало вашего промпта должно абсолютно точно, символ в символ, совпадать с ранее отправленным текстом.
Важно:
Как вы, наверное, уже догадались, если в середине большого диалога вы добавите или удалите скилл или MCP-сервер или поменяет CLAUDE.md или измените что угодно из того, что попадает в контекст - у вас кэш обнуляется и весь ваш диалог обработается и просчитывается заново c нуля с соответсвующими затратами по токенам.
В OpenRouter есть специальная отметка для кэшируемых запросов.
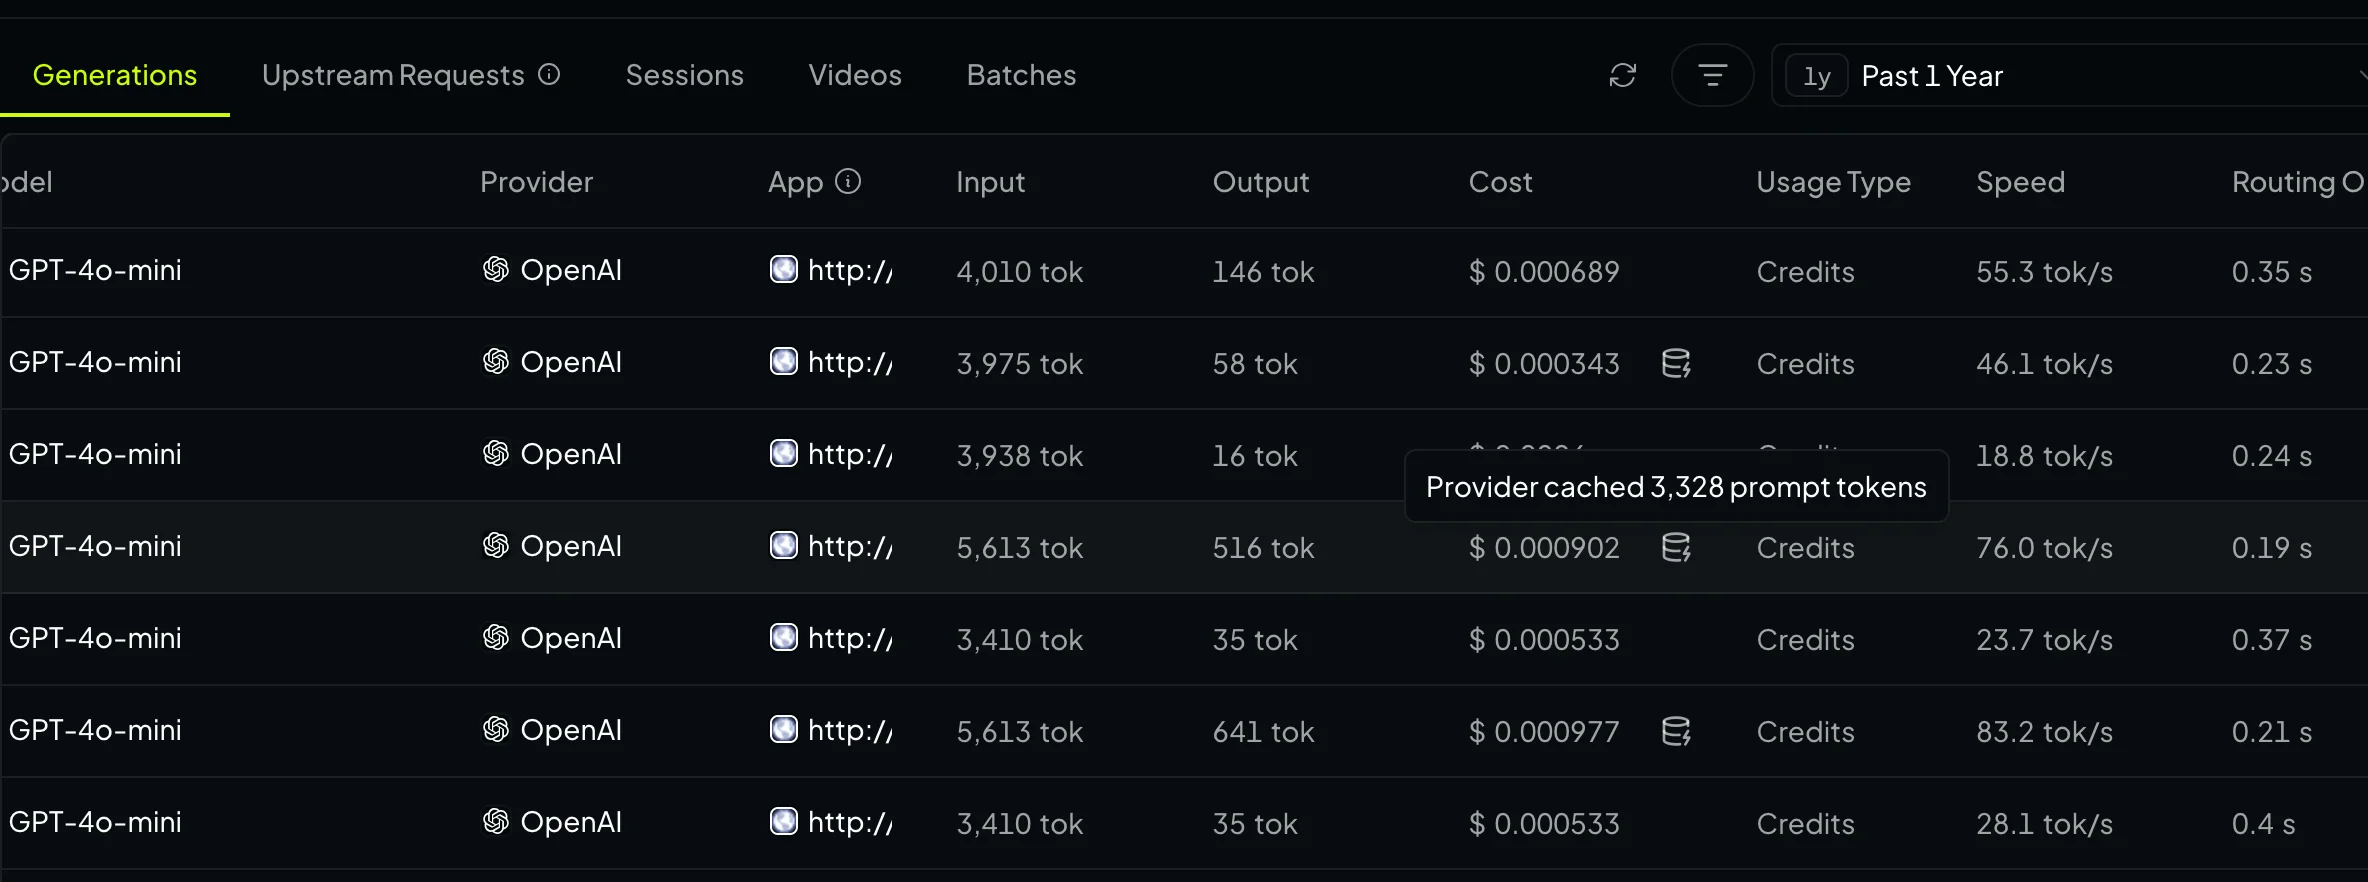
Примечание:
У облачных моделей, чтение из кэша тоже стоит денег.
Обычно это 10% от стоимости входных токенов.
У кэша есть время жизни это может быть 5 минут, либо один час для корпоративных моделей по обычным подпискам.
Базовая гигиена при работе с контекстом
Каждая задача = новая сессия. Если пытаться делать несколько задач в разных частях вашего проекта в одной сессии, нейронка начнет глючить и может делать изменения в тех местах, где вам не нужно. Используйте команду
/newили создавайте новый тред, если вы работает в режиме ACP или в CodexЗапихивать в контекст всю доступную информацию неправильно, правильно запихивать всю необходимую информацию
Держать все время доступными все MCP-сервера плохо, подключайте только необходимые перед тем, как написать свой первый промт
Помните про правила кэширования из прошлой главы, не добавляйте MCP-сервера и скиллы в середине вашей сессии, не меняйте CLAUDE.md в середине сессии
Не забивайте контекст больше 70%
Если задача требует действительно много контекста - просите нейронку использовать субагентов. Например, вы можете сказать нейронке:
Проанализируй проект и составь план по добавлению английского языка
в интерфейс при помощи i18n.
Разбей этот план на задачи, понятные LLM.
И выполняй эти задачи при помощи субагентов.
Это позволит выполнять небольшие задачи в отдельных контекстах, а в основной контекст получать только результат работы.
Если у вас запустилось автоматическое сжатие контекста - это значит, что вы делаете что-то неправильно
Обычно это происходит, если вы не соблюдаете правила, написанные выше. При сжатии контекста - теряется большая часть логической цепочки. Как правило, после сжатия контекста, результат выполнения вашей задачи становится все хуже и хуже. Поэтому, лучше до этого не доводить.