
Урок
1.2 Какие модели подходят для кодинга? Шпаргалка по типам моделей: Instruct, Thinking, Densed, Multi-modal, MOE, MTP, MLX, квантизация
Одному своему коллеге я все уши прожужжал на тему того, что пусть он попробует LLM для решения своей задачи по написанию кода для одной достаточно большой фичи. В итоге он сдался и попробовал, после чего, он долго плевался и недоумевал, насколько нейронка глупая. Я ему ничего не объяснял и не рассказывал, думал сам разберется. В итоге оказалось, что он использовал модель ChatGPT 4-mini для кодинга, это очень маленькая и глупая модель для подобных задач. По этой причине, я решил, что данная статья не будет лишней.
В мире LLM-моделей легко запутаться - их стало очень много. Даже если вы используете подписки - то вам все равно нужно понимать, какая модель для чего предназначена и для каких задач будет достаточно той или иной модели. Вы, конечно, можете для любых задач использовать самую умную модель - но это не эффективно. Топовые жирные модели обычно работают в 2-5 раз медленнее, чем их младшие братья и сестры. Для задачи перевода обычного текста - нет смысла использовать топовую модель, средняя справится также, но в 3 раза быстрее и существенно дешевле. Это как доктора наук заставить решать школьную таблицу умножения.
Если же говорить о локальных моделях - то тут точно нужно хорошо разбираться во всем многообразии, поскольку вам предстоит найти лучшие модели на доступное вам железо. И здесь вы в полной мере ощутите разницу, например, между двумя моделями на 27 миллиардов параметров, одна из которых обучалась почти полностью на чужом коде, а вторая модель общего назначения со встроенным Vision. При написании кода, разница между ними будет космическая.
Какие вообще модели бывают?
Модели бывают очень разные, и я хочу вам рассказать об основных вещах, которые необходимо знать.
По назначению и логике работы (Типы взаимодействия)
Instruct (Инструктивные)
Такие модели не имеют рассуждающего блока и поэтому быстро отвечают. Они не продолжают текст, а просто отвечают на запрос пользователя. Такой тип моделей уже устарел, но для некоторых кейсов его по-прежнему использовать эффективно.Thinking / Reasoning (Рассуждающие)
У рассуждающих моделей есть скрытый этап размышления перед выдачей ответа. Его длительность может отличаться в зависимости от задачи и настроек модели. Эти модели используют цепочки рассуждений (Chain-of-Thought) для решения сложных логических задач.Multi-modal (Мультимодальные)
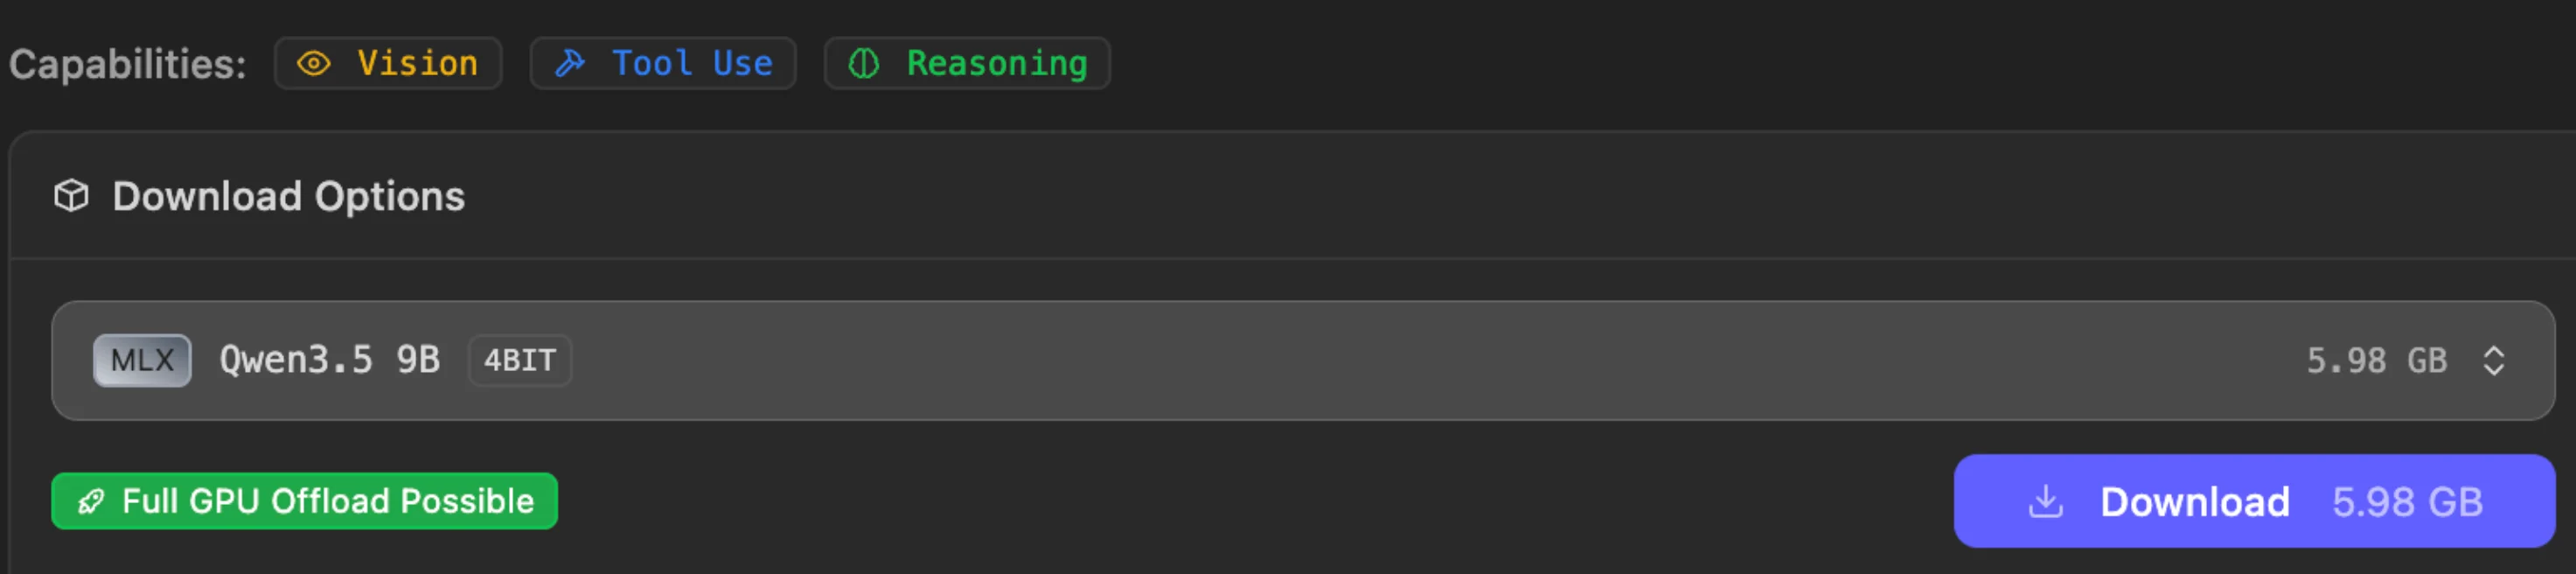
Мультимодальные модели могут обрабатывать не только текст, но также изображение, аудио и иногда даже видео. В контекст вы можете одновременно загрузить тексты и изображения, например. Некоторые модели могут не только принимать разные типы данных, но и генерировать и возвращать текст, изображения, аудио и видео.
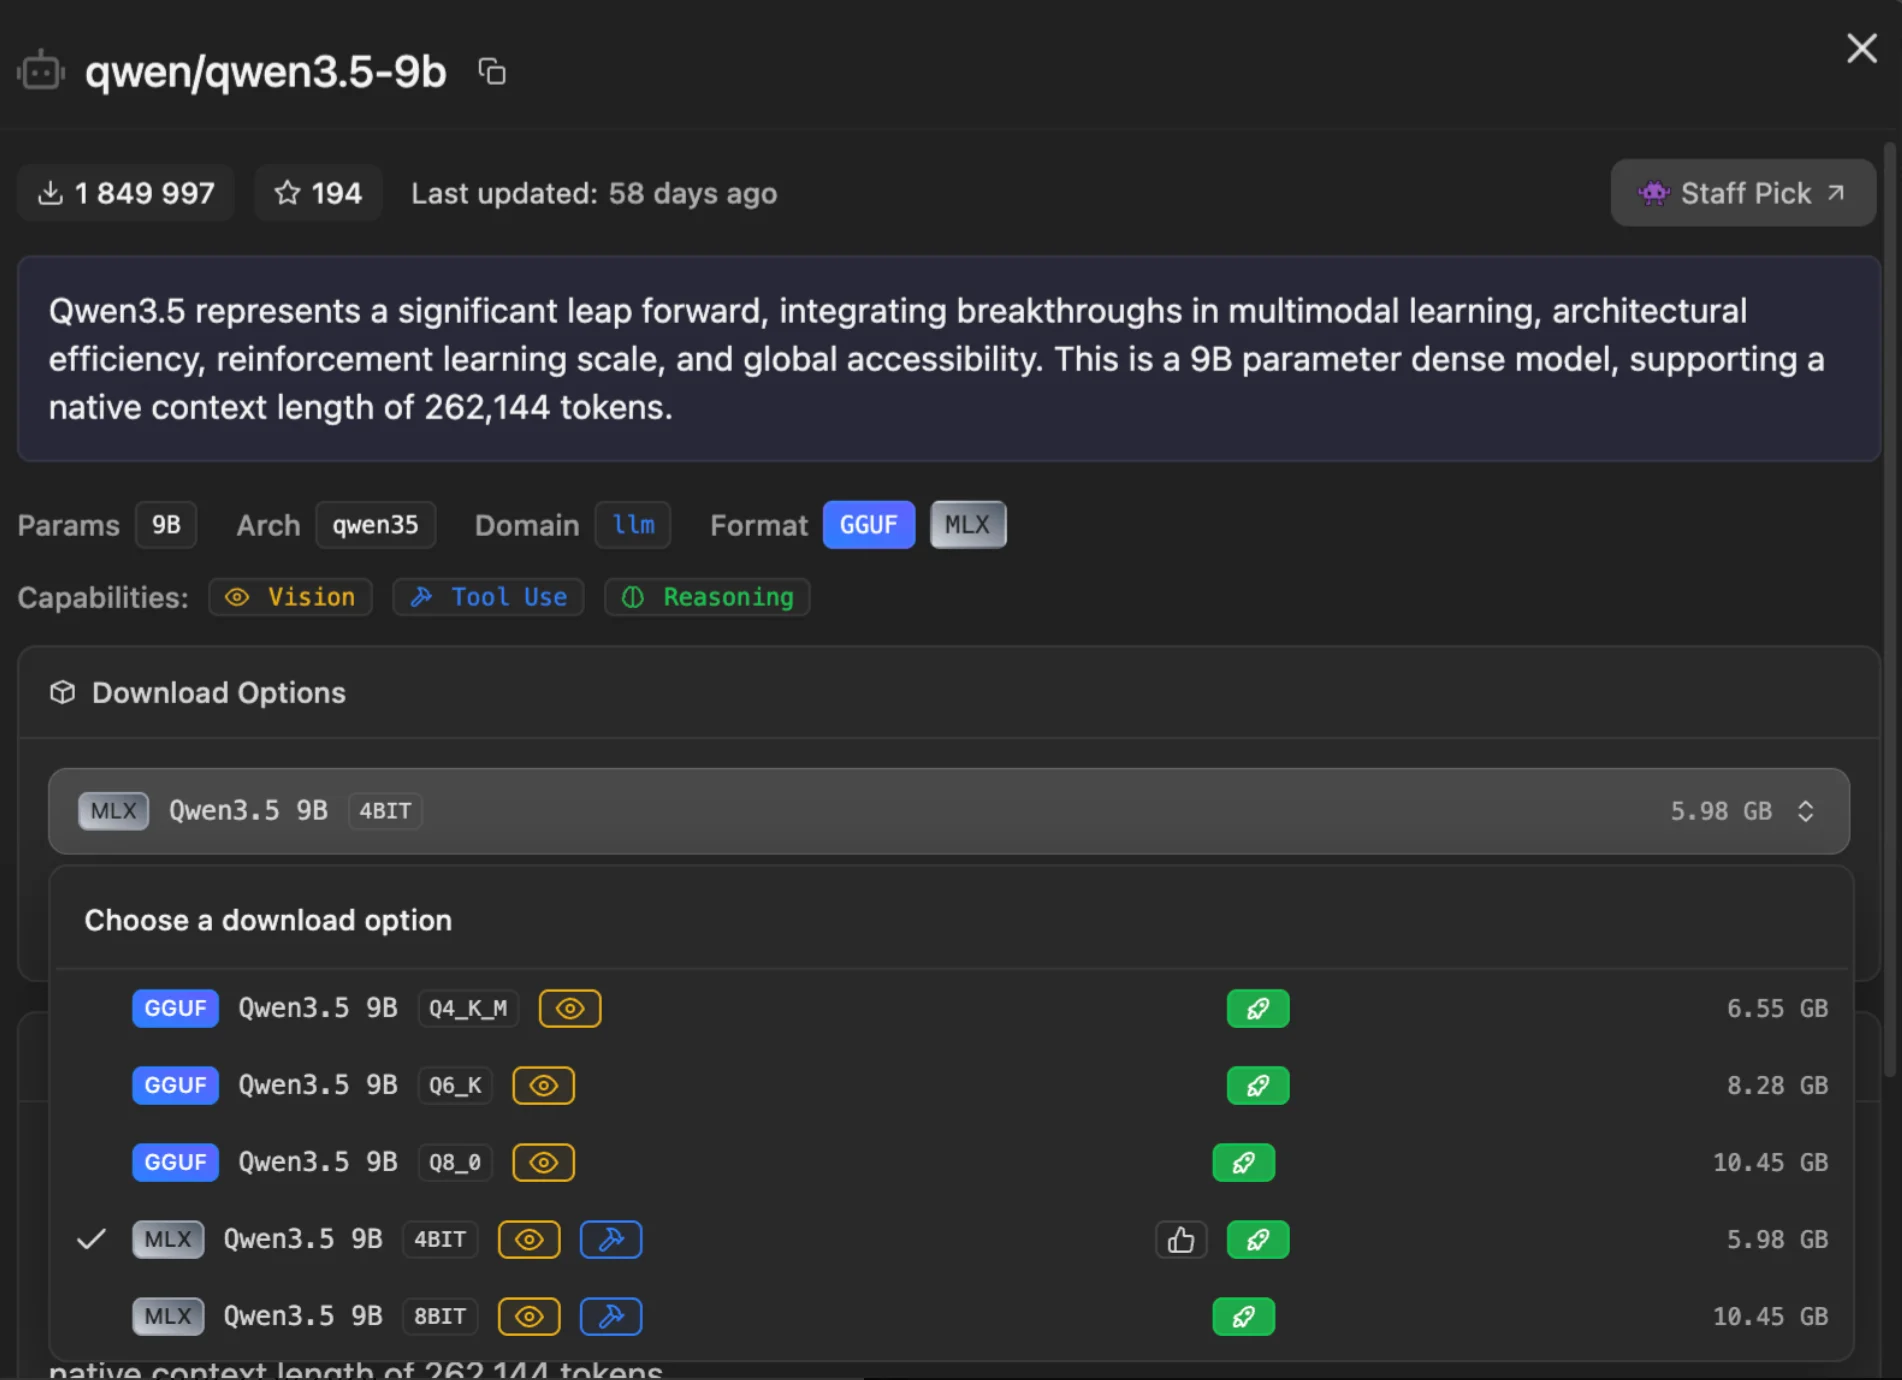
На скрине пример маленькой модели Qwen 3.5 9B, умеющей распознавать изображения, думать и вызывать tools(Capabilities: Vision, Tool use, Reasoning).
По архитектуре и структуре весов
Dense (Плотные)
Это классическая архитектура нейросетей. Для кодинга это замечательно - глубже понимание, чем у MoE, такого же размера. У подобных моделей каждый токен (слово) активирует 100% параметров модели.
Пример: Qwen 3.6 27B
MoE (Mixture of Experts / Смесь экспертов)
Такие модели состоят из большого количества слоев, которые называются экспертами в разных областях. Для каждого токена роутер активирует только часть экспертов (например, 3 из 35). Активация сразу всех экспертов невозможна by design.
Главное преимущество подобного подхода - это скорость работы. Но, несмотря на то, что мы одновременно используем, например, только три эксперта, нам все равно необходимо держать в памяти всех доступных экспертов.
Пример: Qwen3.6-35B-A3B - 3 активных эксперта из 35
По методам оптимизации и форматам
MTP (Multi-Token Prediction / Предсказание нескольких токенов)
Это архитектурный подход, где модель предсказывает не один следующий токен, а сразу несколько. Такой подход ускоряет генерацию текста и улучшает понимание долгосрочного контекста. Позволяет увеличить скорость генерации токенов на 20-200% в зависимости от сложности и рутинности задачи
Пример: Qwen 3.6 27B MTP
Quantization (Квантизация)
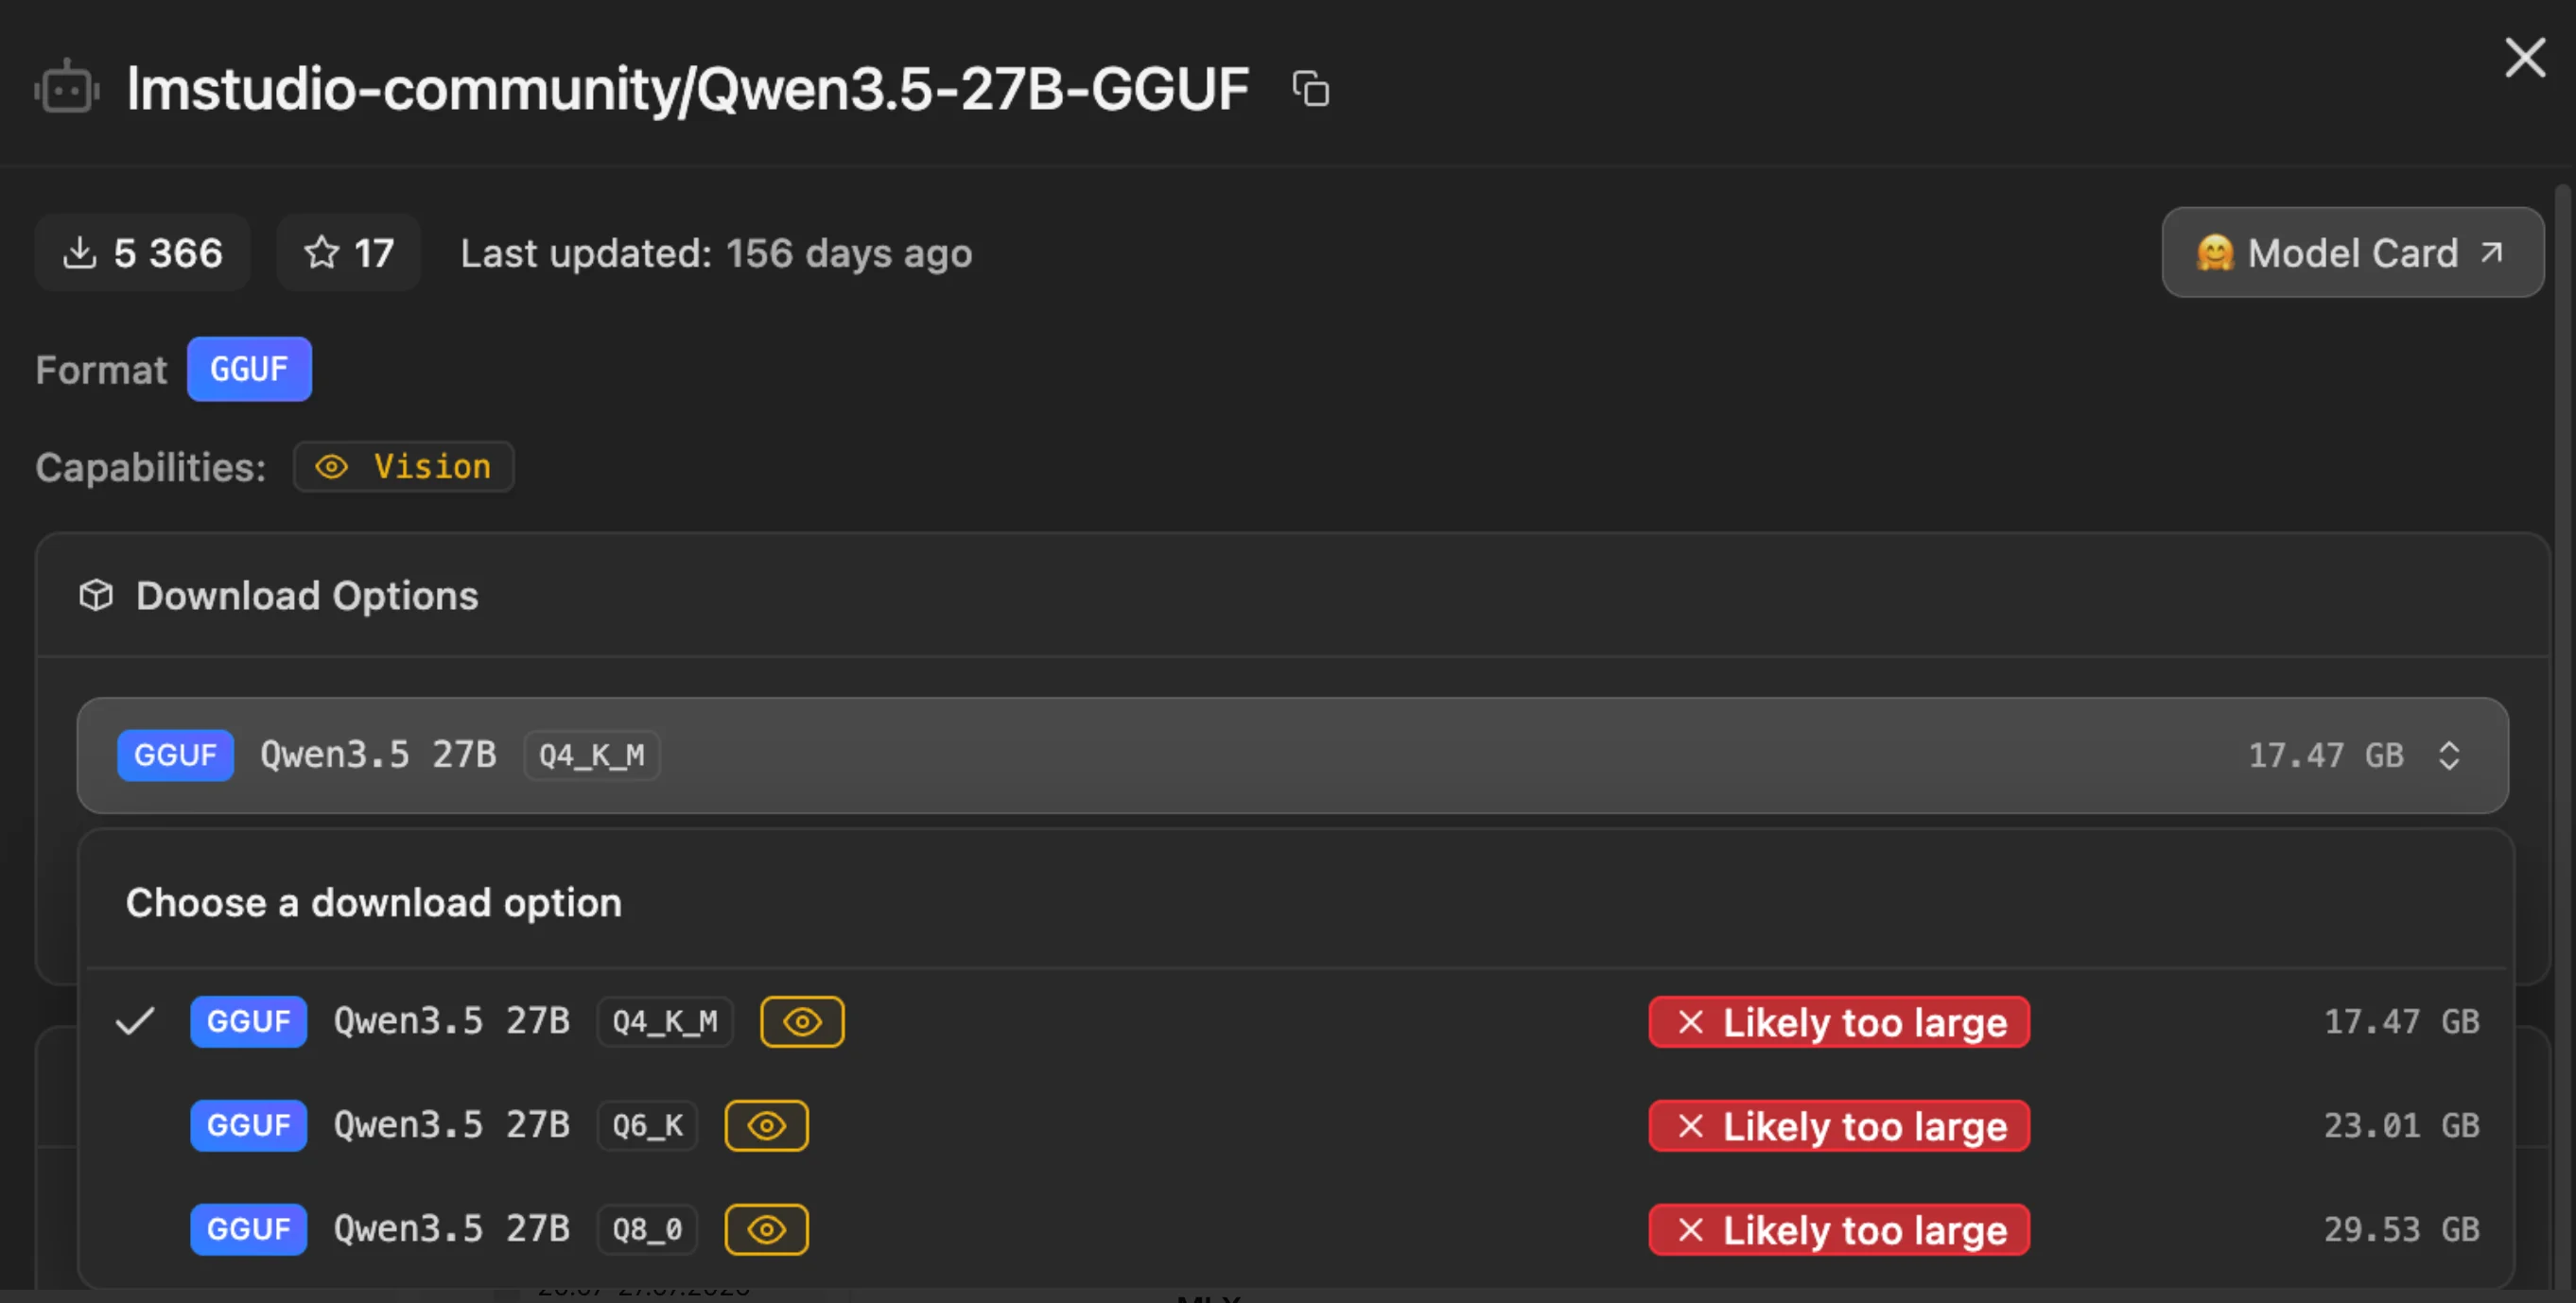
Квантизация - это процесс сжатия модели путем снижения точности числовых весов (например, из 16-бит в 8-бит, 4-бит или даже 1.58-бит). Обычно для домашнего железа выбирают вариант, типа Q4_K_M - это обычно самый оптимальный вариант. Например, Q8_0 будет почти без сжатия и без потерь качества, но потребует сильно больше видеопамяти.Модель - это набор чисел с плавающей точкой, квантизация обычно уменьшает количество знаков после запятой у этих чисел, было 0.3456783945673456, а стало 0.34567839, вместо 16 знаков стало 8 после запятой. Исходный вес модели был 32Гб - стало 8Гб, например.
Скорость генерации модели упирается в пропускную способность памяти(VRAM). Чтобы сгенерировать 1 токен, нужно прочитать все веса модели. Чем больше модель - тем дольше она будет считываться из памяти.
Для примера возьмем видеокарту nVidia RTX 5090 32GB с пропускной способностью памяти в 1792 Гб/сек. . Допустим модель весит 16 Gb. Значит можно очень грубо прикинуть, что модель размером 16 Гб будет иметь скорость генерации(1792/16=112) примерно 112 токенов/секунду, что супер-комфортно для кодинга и быстрее моделей по подписке.
Квантизация позволяет запускать даже очень жирные модели на домашнем железе, а некоторые модели даже на смартфонах. Для квантизации Q4 - потери качества могут составлять 5-10%.
MLX
Это специализированный фреймворк от Apple для эффективного запуска и обучения моделей. Дает прирост в скорости генерации токенов в 20-40%. Оптимизирован под чипы Apple Silicon (M1/M2/M3/M4/M5+).
Модели в формате MLX используют общую память (Unified Memory) Mac на максимальной скорости.
Облачные модели для кодинга по подписке Anthropic(Claude Code), ChatGPT(Codex)
Не буду тут подробно останавливаться. Эти топовые модели используются в том числе для создания новых версий самих себя. Они универсальные - подходят для задач кодинга и для любых других задач.
Хочу вам показать табличку на примере ChatGPT, обратите внимание на скорость.
Сравнение моделей линейки GPT-5.6(31.07.2026)
Модель | Скорость генерации (в среднем) | Стоимость (вход / выход за 1M токенов) | Главное отличие в задачах и назначение | Пример идеального сценария |
GPT-5.6 Sol (Флагман) | ~45–70 токенов/сек (До 2.5× быстрее в режиме Fast) | $5.00 / $30.00 | Сложные многоуровневые рассуждения, глубокий аудит кода, тяжелая аналитика. | Архитектурное планирование, поиск скрытых уязвимостей, комплексный финтех-анализ. |
GPT-5.6 Terra (Баланс) | ~100–120 токенов/сек | $2.50 / $15.00 | Универсальная «рабочая лошадка». Оптимальна для стандартной бизнес-логики и работы с текстом. | Написание и редактирование статей, контент-планы, рутинный рефакторинг кода. |
GPT-5.6 Luna (Скорость) | ~181 токенов/сек (Одна из самых быстрых на рынке) | $1.00 / $6.00 (Дешевле аналогов на 80%) | Сверхбыстрые фоновые задачи, цикличные вызовы в цепочках ИИ-агентов. | Поддержка чат-ботов в реальном времени, структурирование больших данных, массовый парсинг. |
У Anthropic(Claude Code) - картина сопоставимая.
Локальные или корпоративные модели для кодинга Qwen 3.6 27B и Qwen 3.6-35B-A3B
Ловите небольшую таблицу для сравнения.
Сравнение Qwen 3.6 27B и Qwen 3.6-35B-A3B
Характеристика / Критерий | Qwen 3.6 27B (Dense) | Qwen 3.6-35B-A3B (MoE) |
Архитектура | Плотная (Dense) (Все 27 млрд параметров активны всегда) | Смесь экспертов (MoE) (35B всего / только 3B активных параметров) |
Скорость генерации (Tokens per Second) | ~25–40 токенов/сек (До 160 т/с на топовых GPU с MTP) | ~105–135 токенов/сек (До 240+ т/с на топовых GPU с MTP) |
Скорость обработки инпута (Prefill Speed) | ~800–1000 токенов/сек | ~3000+ токенов/сек (В 3 раза быстрее обрабатывает контекст) |
Требования к VRAM (Для локального запуска) | ~18–28 ГБ (Комфортно помещается в 24 ГБ в кванте Q4_K_M) | ~24–38 ГБ (В режиме FP8/Q8 требует больше видеопамяти) |
Сила в задачах | Глубокая логика, безошибочный кодинг, сложные агентские цепочки, строгое следование длинным инструкциям. | Сверхбыстрые ответы, RAG (работа с базами знаний), многопользовательские чаты, первичный парсинг данных. |
Поведение при нехватке VRAM | Падение скорости не столь критично, можно частично выгрузить в RAM. | Скорость резко падает, если «эксперты» MoE не помещаются в VRAM целиком. |
Для локального кодинга - Qwen - фаворит. Но также вы можете рассмотреть Deepseek и GLM.
Не буду перегружать ваш лишней информацией - этого пока будет достаточно.